独立开发者()

中文母语水平
0
1
2
3
4
5
专注 Python 数据采集与自动化处理,主要接三类活:网页数据采集、数据清洗归档、Excel 批量处理。
做事方式:接单前先确认三件事——目标站点能不能抓、需要的字段有哪些、多久更新一次。确认完给明确报价和交付时间,不接含糊需求。
交付内容:可运行的源码、字段说明、一次免费修改。跑不通我负责改到跑通。
擅长处理带反爬、需要登录、需要翻页的站点;做过请求签名逆向,能从压缩过的前端代码里还原加密参数;能把采集做成定时任务,每天跑完自动把结果发到指定邮箱或网盘。
不接:涉及个人隐私信息的采集、需要破解他人账号的需求。
2026-04-25 -2026-10-28个人工作室独立开发者()
以独立开发者身份承接 Python 相关项目,主要方向为数据采集与自动化处理。 · 承接网页数据采集需求,完成目标站点结构分析、反爬策略处理与数据落地 · 使用 Playwright 处理动态渲染页面与登录态场景 · 对采集结果做清洗、去重、字段归一,输出结构化 Excel/CSV 交付 · 编写定时任务实现周期性采集与结果推送,配套异常重试与运行日志 · 与需求方直接对接,负责需求澄清、方案说明、交付验收与后续维护
2021-09-01 - 2024-06-30三台绵阳初中。机电初中及以下
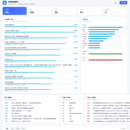
系统分四个模块。一、多源采集:B站排行榜、豆瓣热门电影、CSDN技术热榜并发抓取,单源失败不影响其它源。二、统一入库:数据存SQLite,按平台加条目做唯一键upsert,重复采集不会产生冗余行。三、趋势分析:每轮采集落一份快照,用窗口函数算两次之间的播放差,输出增量榜;同时按(点赞加投币)除以播放
 0
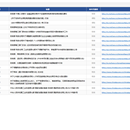
工具分四个模块:①多源抓取:并发访问财政部、税务总局、生态环境部等站点的政策栏目,单个站点失败不影响其他站点,日志区分[完成]/[跳过]/[异常]。②内容解析:从列表页提取标题、链接与发布日期,自动把相对路径补全为绝对地址,并过滤「首页/下一页/京ICP备/微博」等导航噪声。③过滤去重:支持多个关键
0