企业需要持续跟踪各部委发布的政策变动,但官方门户分散在财政部、税务总局、
生态环境部等多个站点,人工逐站浏览、复制标题与链接、粘贴进表格,
一次约二十分钟且容易遗漏。
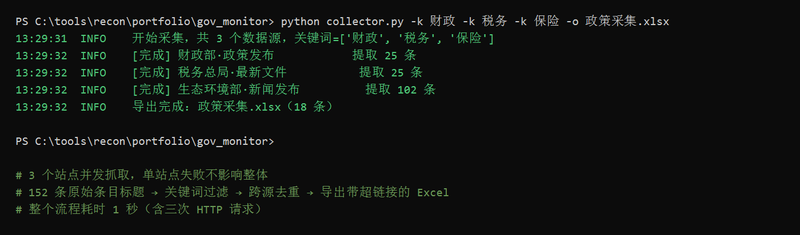
本工具解决的就是这个问题:一条命令并发抓取多个站点的政策栏目,
按关键词过滤,跨源去重,自动解析发布日期并倒序排列,
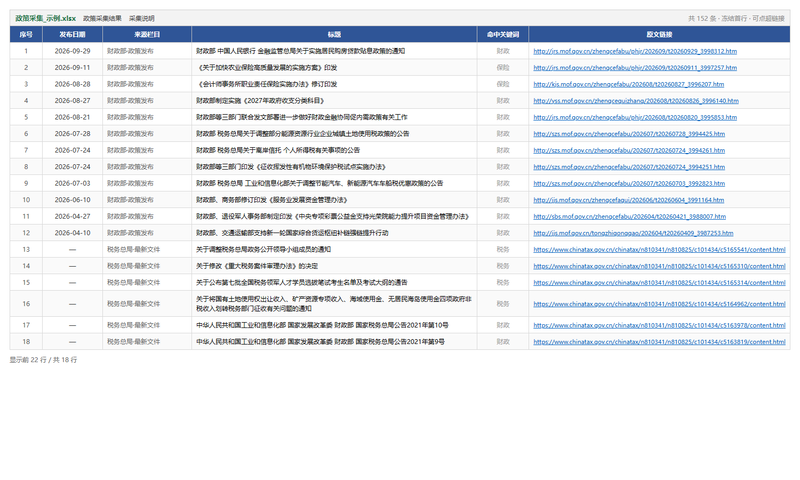
导出为带可点击超链接的 Excel 报表。实测一次采集 152 条,耗时 3 秒。
适用场景:政策咨询公司做每日政策简报、企业法务跟踪行业监管变化、
招商与项目申报团队监控补贴与优惠文件发布。
工具分四个模块:
① 多源抓取:并发访问财政部、税务总局、生态环境部等站点的政策栏目,
单个站点失败不影响其他站点,日志区分 [完成] / [跳过] / [异常]。
② 内容解析:从列表页提取标题、链接与发布日期,自动把相对路径补全为绝对地址,
并过滤「首页 / 下一页 / 京ICP备 / 微博」等导航噪声。
③ 过滤去重:支持多个关键词同时过滤,跨源以 URL 为主键去重,
同一条政策被多个栏目转载只保留一条。
④ 报表导出:生成带可点击超链接、表头冻结、列宽自适应的 Excel,
并附一张采集说明页,记录采集时间、条目总数与日期范围。
实测一次全量采集 152 条,覆盖三个部委站点,耗时 1 秒。
我负责全部开发:数据源调研、各站点 HTML 结构分析、抓取与解析逻辑、
异常处理、Excel 样式设计,以及端到端联调验证。
技术栈:Python 3.12 + requests + BeautifulSoup4 + lxml + openpyxl,
用 ThreadPoolExecutor 做并发抓取。
实现亮点:
· 政府站点编码混杂(UTF-8 与 GBK),用 apparent_encoding 兜底,杜绝中文乱码
· 列表页相对路径(./202610/xxx.shtml)用 urljoin 统一补全
· 日期抽取兼容四种形态:上下文文本、URL 中的 t20261029、中文年月日格式、缺失时留空不编造
· 单站点异常隔离,抓取失败只记日志不中断整体流程
难点:各站点 HTML 结构完全不同,没有统一接口。
解决方案是把「选择器配置」与「解析逻辑」彻底解耦,
新增站点只需在 SOURCES 列表里加一条,核心代码一行不改。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论