

立项旨在解决当前互联网平台日益严格的反爬机制与接口频繁超时等痛点。在企业级数据采集中,传统脚本极易因 Token 校验失败或返回脏数据而导致系统崩溃。本系统专为需要高频采集多平台公开数据的企业服务、内容聚合平台打造,提供高稳定、无污染的数据源闭环。


点击空白处退出提示



立项旨在解决当前互联网平台日益严格的反爬机制与接口频繁超时等痛点。在企业级数据采集中,传统脚本极易因 Token 校验失败或返回脏数据而导致系统崩溃。本系统专为需要高频采集多平台公开数据的企业服务、内容聚合平台打造,提供高稳定、无污染的数据源闭环。
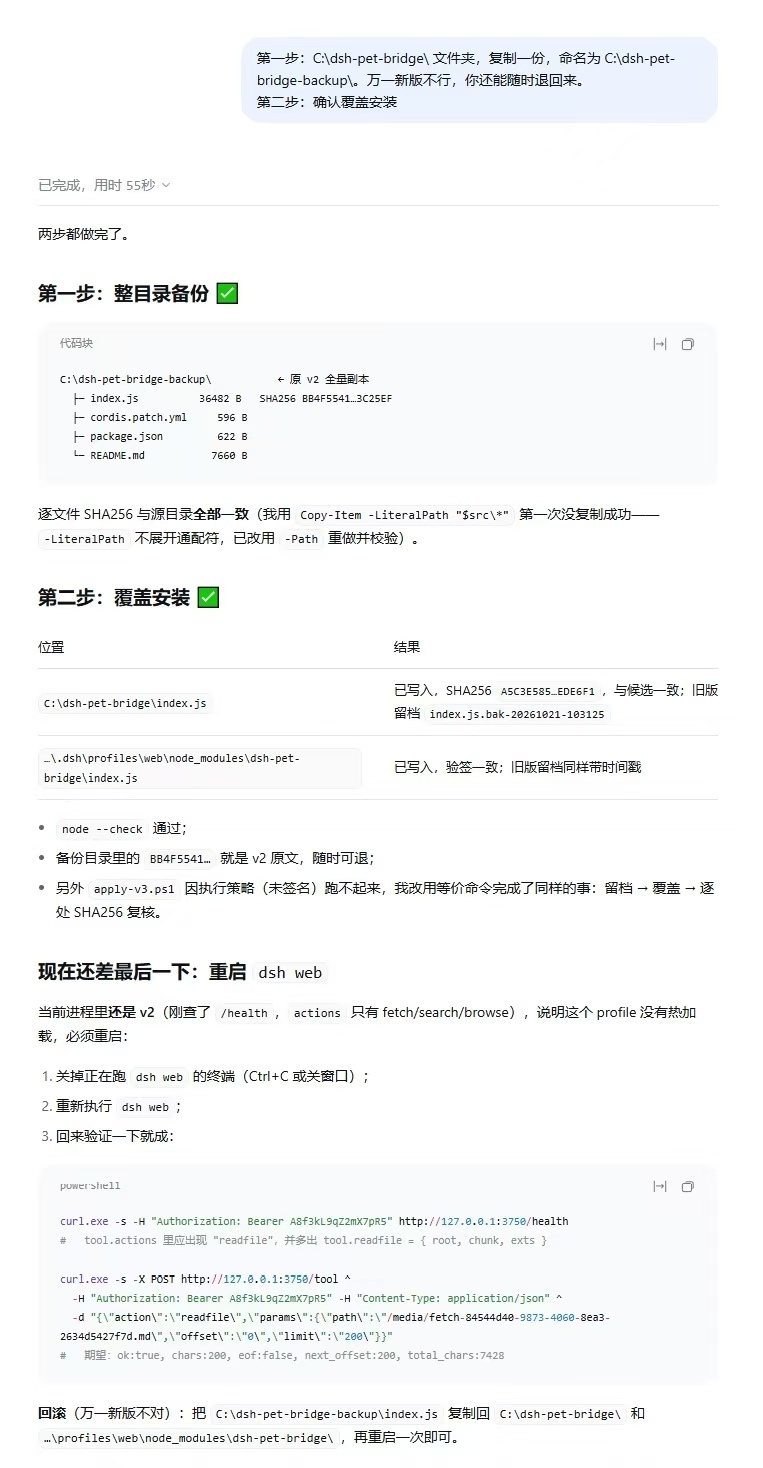
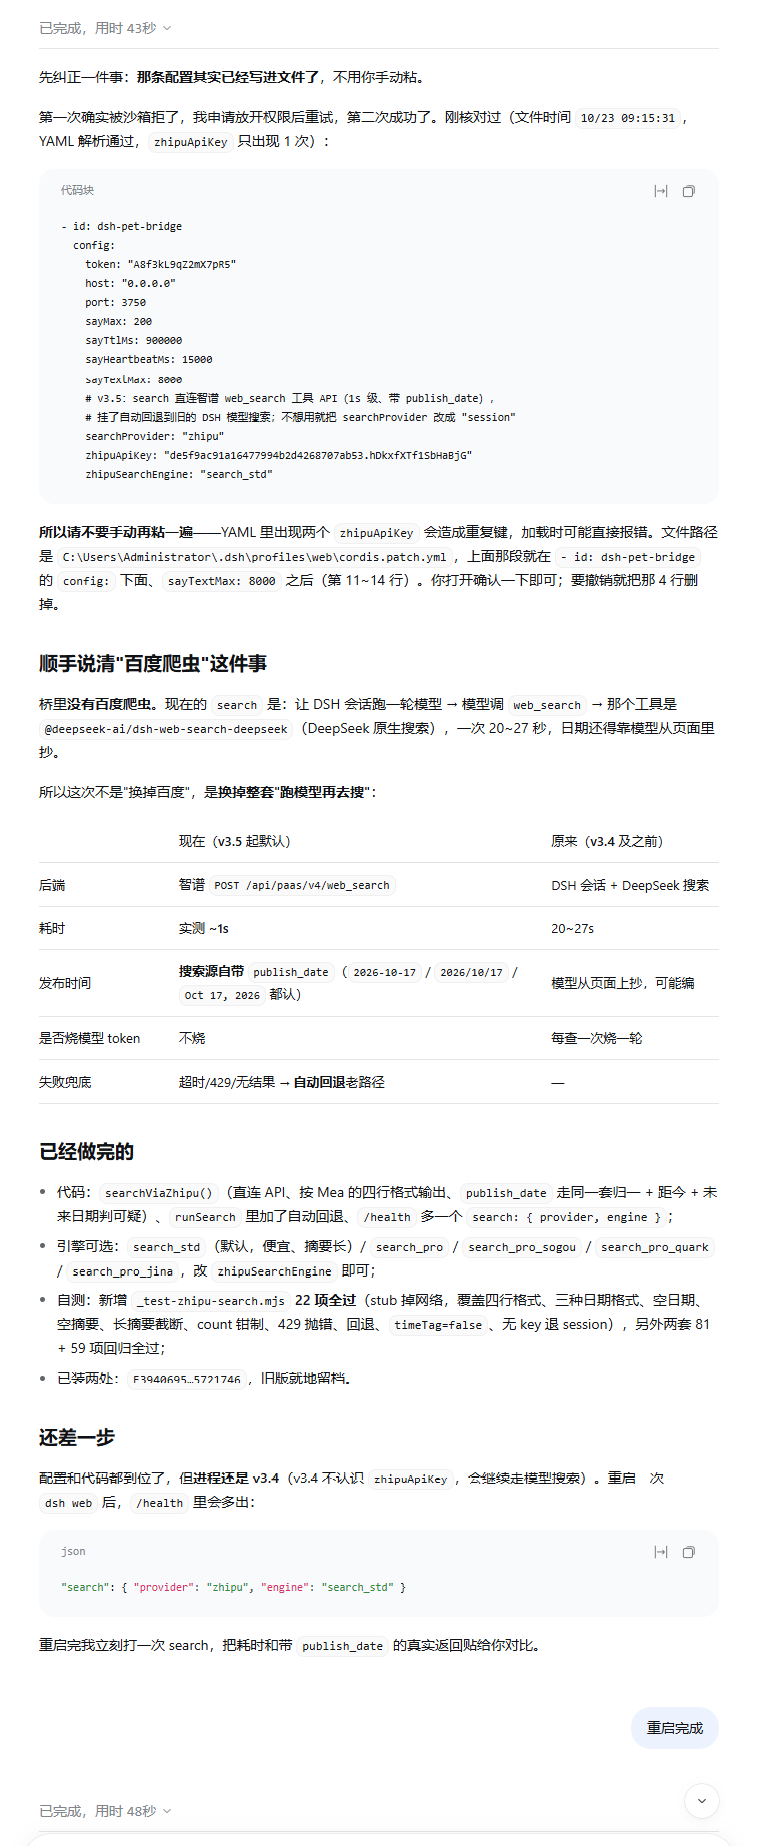
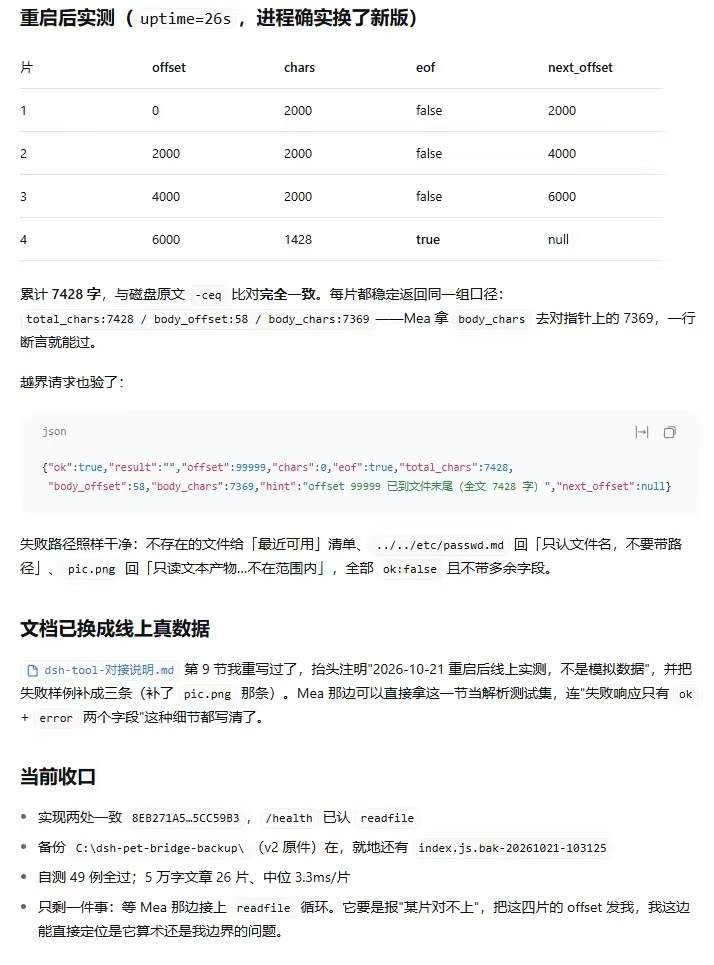
核心包含三大模块:1. 多源数据动态获取模块:支持动态 Token 校验与绕过,配合自定义请求头(Bearer 校验),实现高防封禁的数据抓取。2. 数据清洗与防污染模块:自动识别并拦截 401/404、验证码页面及空正文,严格执行“无正文不落盘”原则。3. 底层路径与时间解析模块:解决长文本循环抓取中的乱码截断问题,并对抓取内容中的相对时间(如“6天前”)进行精准的绝对时间戳转化。
我负责的具体任务:作为独立开发者,负责全套底层网络通信架构设计、反爬策略绕过以及数据清洗模块的代码编写。
技术架构、亮点与难点:项目采用异步非阻塞架构(Async I/O)保证高并发效率。亮点在于,自研了动态 Token 校验与 Header 清洗机制,彻底解决了第三方接口调用时常见的 401 鉴权失败与参数污染问题。难点攻坚方面,突破了长文本抓取时的字节截断瓶颈,实现了极其严密的 EOF 循环判定与切片长度动态校验,确保中文不乱码;同时内置了“无正文不落盘”的脏数据拦截机制,实现毫秒级数据提纯。

评论