过去,企业经营分析主要依赖内部的订单、库存、财务和客户数据。随着线上业务普及,决策
所需的信息越来越多地来自组织外部:竞品的价格与上新节奏、平台的商品结构、用户评价与舆
情、招聘岗位与技能要求、行业新闻与政策变化等。这些信息通常以网页形式公开,却不一定提供
稳定、完整、可批量调用的 API。
由此产生的现实问题是:数据就在网页上,但难以低成本地变成结构化数据。网络爬虫(Web
Crawling)因此成为数据采集的基础技术之一。它把非结构化的 HTML 页面解析为结构化记录,再
经过清洗、去重、统计和可视化,进入分析流程。
本项目面向的正是这一中间环节:不追求做“大而全”的采集平台,而是提供一条 轻量、透
明、可复现的“采集—清洗—统计—呈现”流水线,让小团队和个人也能快速完成一次外部数据分
析。
2.3.1 分类与翻页
适配器负责三件事:
categories():从入口页解析分类及分类 URL;
items():从列表页解析一条条记录;
next_page():返回下一页 URL,最后一页返回 None。
采集引擎按“分类 → 列表页 → 翻页”遍历,自动注入分类名、页码和采集时间。对没有分类的站点,适配器可以返回一个“全部”伪分类,降低接入成本。
2.3.2 合规与稳定性
默认读取并遵守 robots.txt,按站点缓存解析结果;
请求之间强制最小间隔,默认 0.35 秒;
对 429/500/502/503/504 做指数退避,支持 Retry-After;
404/410 直接跳过,不浪费重试;
网络异常、超时、解压失败分类处理;
单页解析异常不会拖垮整个任务,记录错误后继续下一个分类;
支持 --max-pages、--limit 控制抓取规模,便于试跑。
2.3.3 编码纠正
真实站点常出现 header 声明 ISO-8859-1、正文实际是 UTF-8 的情况。系统按以下顺序判定编码:
有 BOM 时按 UTF-8-SIG;
读取 Content-Type 的 charset;
若声明缺失或属于 ISO-8859-1/Latin-1/ASCII,读取正文 ;
仍不可信时,依次尝试 UTF-8、GB18030,最后回退 CP1252。
这套策略覆盖了英文站、中文站和“header 撒谎”的常见情况。
2.3.4 断点续爬
每抓完一页,系统把 url → next 写入 temp/visited_pages.jsonl。重启后:
已在检查点中的页面直接跳过,不重复请求;
仍然保留 raw 数据去重复核,防止检查点缺失导致重复写入;
翻页循环有 seen_pages 保护,避免站点错误链接造成死循环;
按 Ctrl+C
清洗层实现
清洗流程:
逐条 normalize_record():标题、URL、分类、价格、星级、库存、标签;
按统一键去重;
用全部有效价格计算分档边界;
用 1.5×IQR 标记异常价;
排序、统计质量指标、返回 CleanResult
统计层实现
统计层不依赖 pandas,核心函数包括:
_quantile(ordered, q):线性插值分位数;
_mean / _stdev:均值与样本标准差;
_pearson(xs, ys):皮尔逊相关系数,方差为 0 或样本不足时返回 None;
compute_stats():组装 KPI、分类表、分布、交叉、极值、相关、标签/作者、质量、结论
图表实现
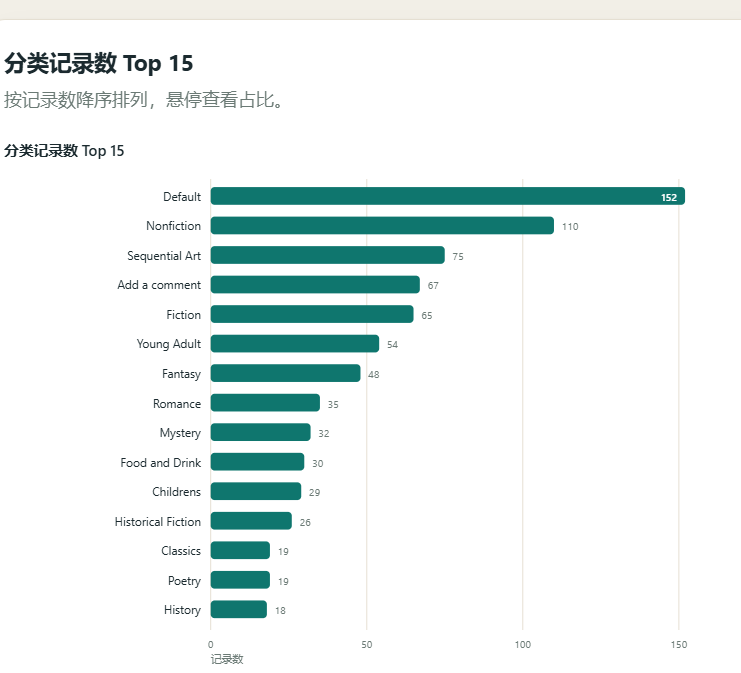
条形图:按记录数排序,左侧标签按显示宽度截断,超长条的值标签放在条内;
环形图:用 stroke-dasharray 画扇区,中心显示总数,右侧图例显示数量与占比;
柱状图:适合 5 个价格区间,柱顶显示数量,底部显示占比;
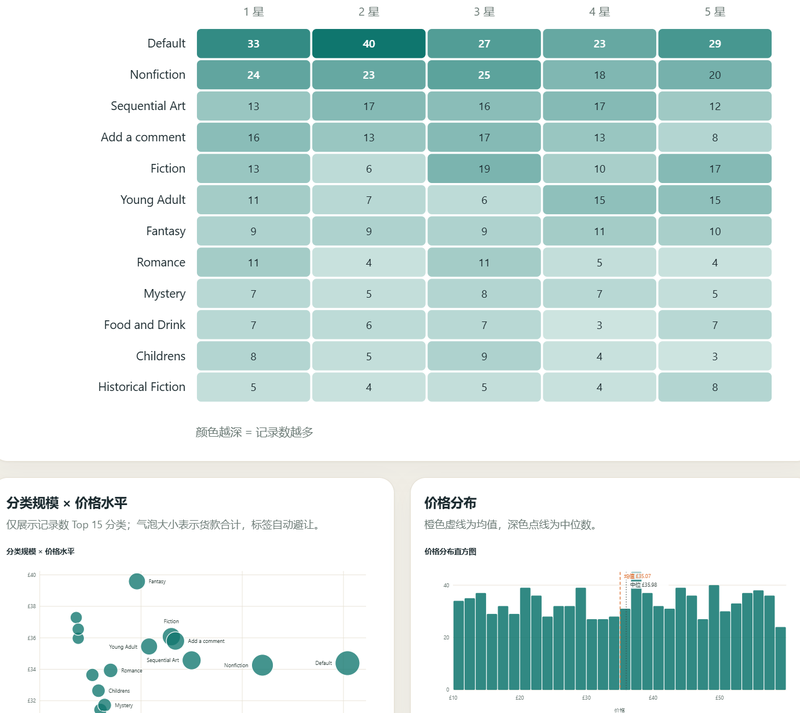
热力图:颜色深浅映射记录数,单元格文本按背景明暗自动切换黑白;
气泡图:x 为记录数、y 为均价、气泡面积为金额合计;只展示 Top 15 分类;
直方图:自动分箱,均值/中位虚线,标签带白色底衬避免压住柱子。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论