

企业内部沉淀大量 PDF 文档,包括客户档案、制度文件、培训资料,人工查阅效率低。本项目面向企业文档问答场景,实现文档智能检索、问答溯源,降低信息查找成本,减少大模型回答幻觉。


点击空白处退出提示
 1


企业内部沉淀大量 PDF 文档,包括客户档案、制度文件、培训资料,人工查阅效率低。本项目面向企业文档问答场景,实现文档智能检索、问答溯源,降低信息查找成本,减少大模型回答幻觉。
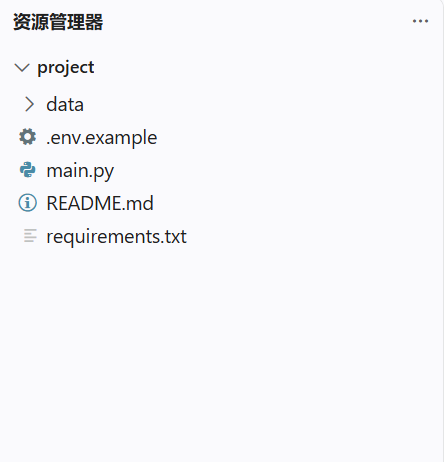
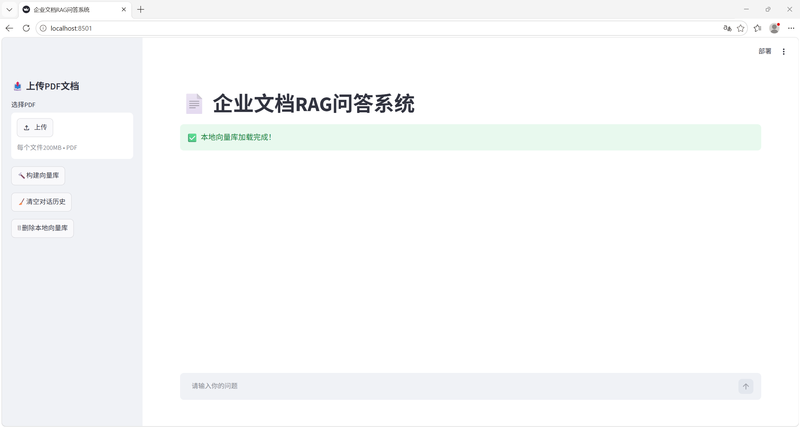
支持批量解析多份 PDF 文档,自动文本切片并构建向量知识库;采用 FAISS 向量检索 + BM25 关键词检索混合召回,搭配 CrossEncoder 重排优化检索精度;支持多轮对话、代词追问;Streamlit 可视化网页交互,回答附带原文来源溯源;向量库持久化,一次构建可反复调用,可私有化部署。
本人独立完成 RAG 全链路开发,使用 Python 作为开发语言,基于 LangChain、FAISS 向量库、BM25 关键词检索、CrossEncoder 重排、Streamlit 网页框架、Pydantic 参数校验库进行开发。负责文档解析、文本切片、检索策略开发、大模型 API 对接与 Web 页面开发,解决实体串扰、检索不准、回答幻觉等痛点,可分阶段交付源码与部署文档

评论