

针对企业财务、行政及采购部门在处理海量电子发票、收据等 PDF 文件时,面临的“人工逐个打开复制粘贴效率极低、易看错行、金额录入错误”等业务痛点。旨在解决跨部门报销或对账流程中,PDF非结构化数据向 Excel 结构化数据转换的难题,极大释放人力。


点击空白处退出提示



针对企业财务、行政及采购部门在处理海量电子发票、收据等 PDF 文件时,面临的“人工逐个打开复制粘贴效率极低、易看错行、金额录入错误”等业务痛点。旨在解决跨部门报销或对账流程中,PDF非结构化数据向 Excel 结构化数据转换的难题,极大释放人力。
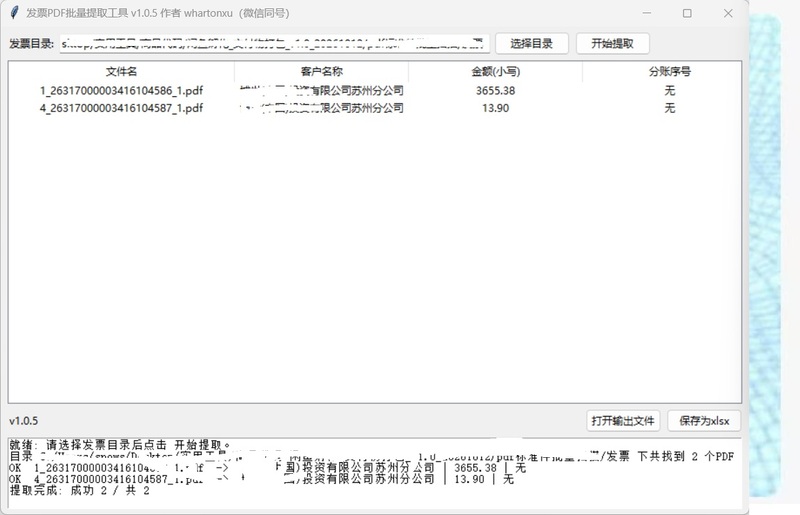
核心包含:1. 纯本地文件夹批量扫描与 PDF 文本提取引擎;2. 发票核心字段精准解析(客户名称防错截断、金额多级正则回退提取、分账序号智能识别);3. 图形化表格预览(GUI);4. 一键导出规范化的 XLSX 报表。主要功能为:实现多份发票文件秒级结构化,并允许用户直接打开生成的文件。
本人负责全部架构设计与底层防呆逻辑编写。技术栈采用 Python + Tkinter + pdfplumber + openpyxl。实现亮点:1. 强容错解析规则:针对不同版式发票,编写多级正则回退机制,防止税号混入客户名或金额漏抓;2. 纯本地单机运行,断网可用,杜绝企业税务数据外泄风险;3. 异常独立拦截,单张发票解析失败不影响整批处理,并留痕提示。


评论