

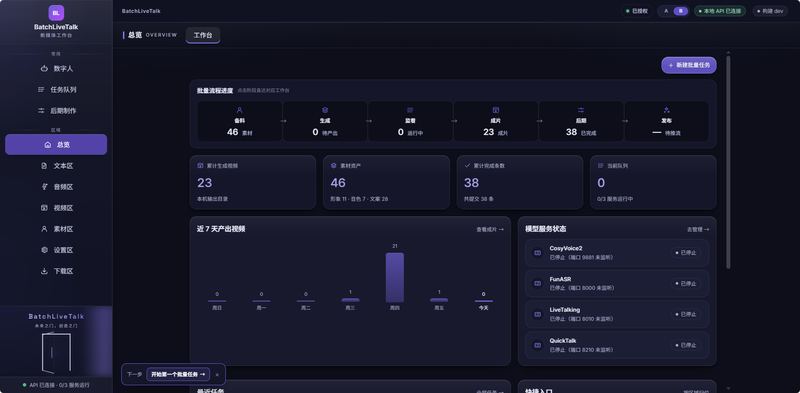
适用于现如今当下的自媒体工作流;支持批处理产出数字媒体作品。当下流行的数字人本地模型部署,语音模型部署等


点击空白处退出提示



适用于现如今当下的自媒体工作流;支持批处理产出数字媒体作品。当下流行的数字人本地模型部署,语音模型部署等
核心功能
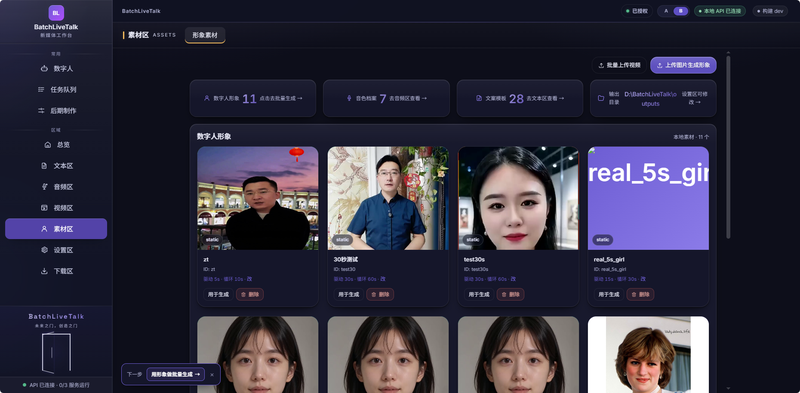
01 数字人形象:一张照片就能开口说话
上传一张人像照片,即可生成可驱动的数字人形象;也支持短视频素材。形象统一入库管理,一次登记长期复用。
- 支持「自然眨眼」模式,画面不是一张僵住的图
- 多个形象并存,不同内容用不同人设
- 形象卡片可直接「用于生成」,不必再翻素材目录
形象素材
02 声音克隆:10–60 秒素材,复刻一个专属音色
上传一段参考音频即可登记音色。mp3 / wav / m4a 都行,视频文件也能直接传——系统会自动提取音轨。
不用你填参考文本:登记时会自动截取 3–10 秒干净人声、自动识别文字稿、自动定稿保存。
声音克隆
03 文本转语音:细到可以调的配音
基于本地 GPT-SoVITS,选音色、给文本,直接出配音。
- 合成粒度三种:整段一条、按句、按行(多条独立文案按行切最省事)
- 语速可调;音色下拉直接选已登记档案
- 高级参数开放:扩散步数、采样温度、top_p / top_k、重复惩罚、随机种子、文本切分方式
- 合成结果自动进「语音库」,可试听、改名、下载
文本转语音
04 批量出片:一批语音,一次提交
选好形象、把多条语音一次性导入,系统按「一条语音 = 一条视频」批量产出,底部实时显示「将生成 N 条视频」。
- 逐条语音独立成片,互不干扰
- 支持直接勾选语音库里已合成的音频
- 右侧可单条试跑:先验一条看看口型对不对,再整批提交,不白等
- 批次提交后进「任务队列」,进度逐条可见

评论