

在大数据时代,海量数据蕴含巨大价值。本项目旨在解决特定行业数据获取困难、数据非结构化等问题。通过自动化采集技术,快速获取网页公开数据,进行清洗后存入本地,为后续的数据分析与商业决策提供底层数据支持。


点击空白处退出提示



在大数据时代,海量数据蕴含巨大价值。本项目旨在解决特定行业数据获取困难、数据非结构化等问题。通过自动化采集技术,快速获取网页公开数据,进行清洗后存入本地,为后续的数据分析与商业决策提供底层数据支持。
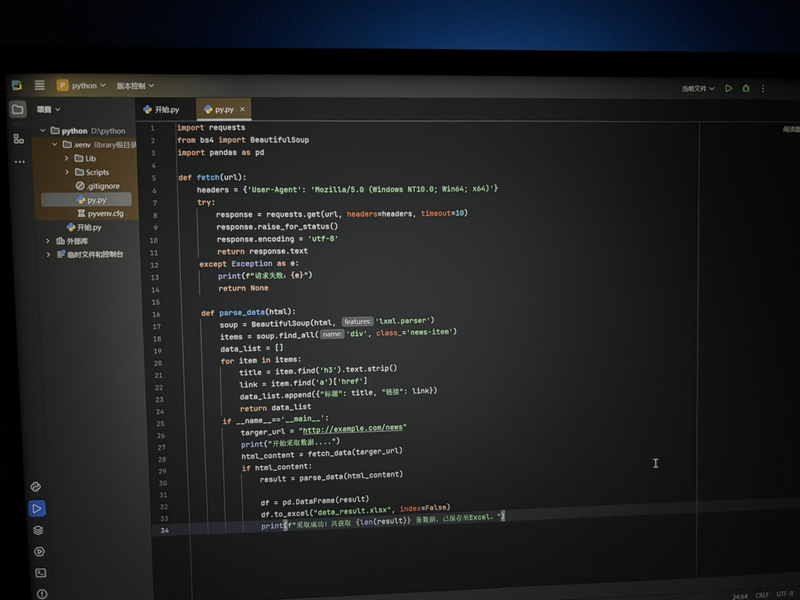
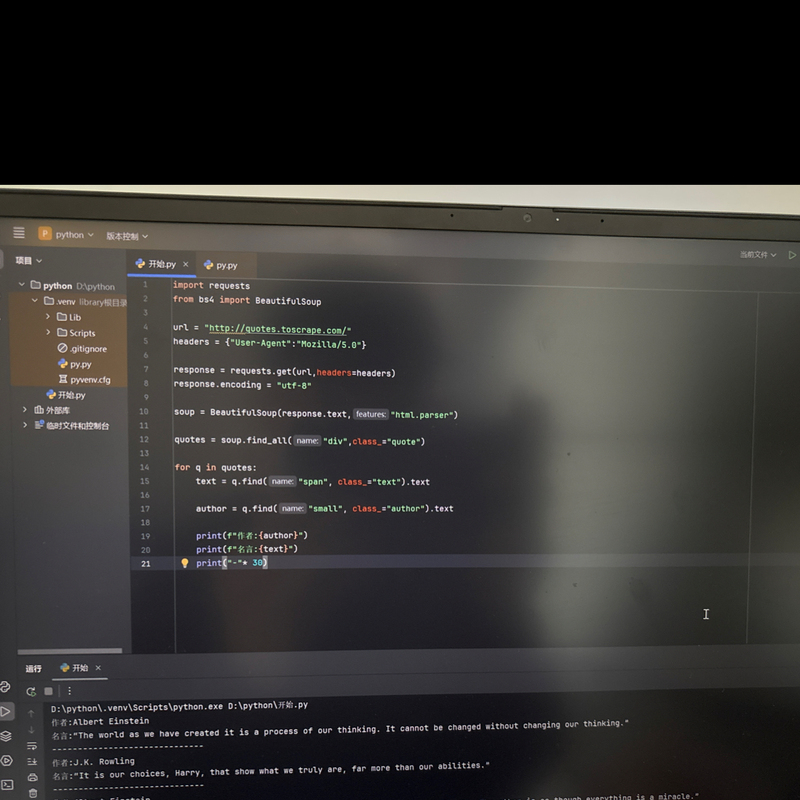
项目主要包含三大功能模块:一是自动化爬虫模块,使用Requests发送网络请求获取HTML源码;二是数据解析与清洗模块,使用BeautifulSoup提取核心字段,去除无效标签;三是数据存储模块,将清洗后的结构化数据存储至CSV文件或数据库中。
本人独立负责整个项目的架构与代码编写。技术栈为Python + Requests + BeautifulSoup + Pandas。实现亮点在于使用了随机User-Agent应对基础反爬机制。难点在于部分页面为动态渲染,后续通过分析Ajax请求找到了真实的数据接口并成功抓取。

评论