

立项原因:旨在解决业务人员在数据监控和调研过程中,面对海量网页数据无法快速抓取、相关附件报表难以批量获取的问题。
业务背景:针对内容平台的数据分析、市场调研场景,往往需要高频次、大批量地采集网页公开数据及相关附件报表,人工采集极易出错。
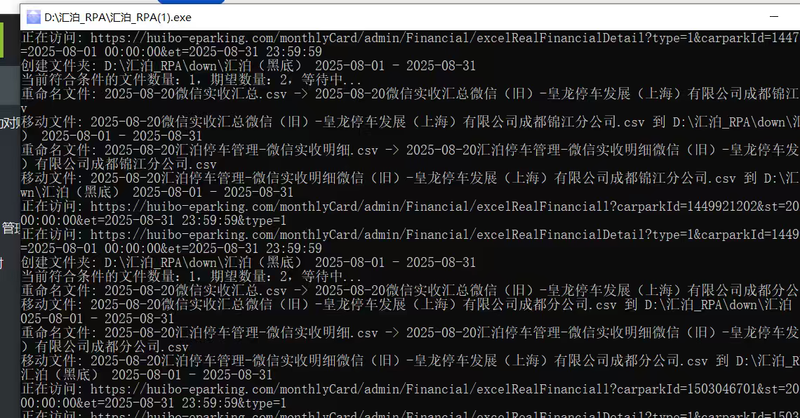
场景描述:本项目开发了一套Windows环境下的自动化采集工具。通过解析网页结构,实现目标数据的精准爬取与清洗,并支持附件文件的高并发/稳定下载。有效解决了数据获取慢、附件下载难的问题,为后续的数据分析提供了及时、完整的数据支撑。


点击空白处退出提示



立项原因:旨在解决业务人员在数据监控和调研过程中,面对海量网页数据无法快速抓取、相关附件报表难以批量获取的问题。
业务背景:针对内容平台的数据分析、市场调研场景,往往需要高频次、大批量地采集网页公开数据及相关附件报表,人工采集极易出错。
场景描述:本项目开发了一套Windows环境下的自动化采集工具。通过解析网页结构,实现目标数据的精准爬取与清洗,并支持附件文件的高并发/稳定下载。有效解决了数据获取慢、附件下载难的问题,为后续的数据分析提供了及时、完整的数据支撑。
本项目主要包含四个核心功能模块:
1. 任务配置模块:支持输入目标网页的URL,可自定义请求头、翻页规则、并发线程数以及下载延迟时间,防止触发风控。
2. 数据解析采集模块:自动识别网页 DOM 结构,精准提取标题、正文内容、发布时间等结构化数据。
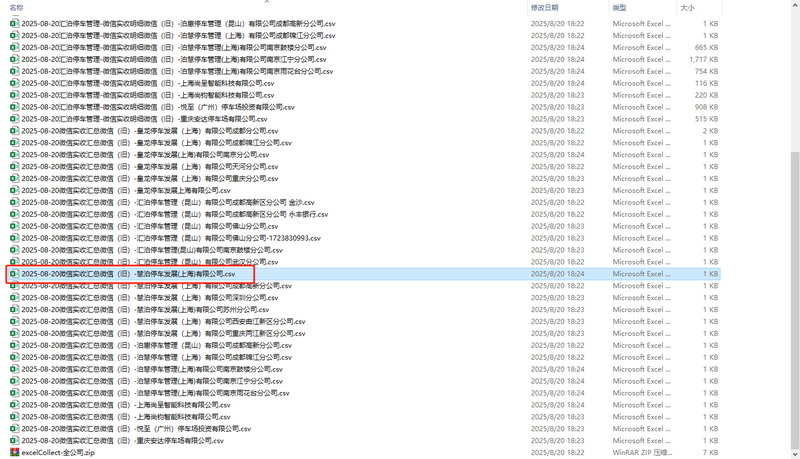
3. 附件批量下载模块:实时监测页面内的文档(如PDF、Word)、图片及压缩包链接,实现附件文件的批量并发下载,并按预设规则(如按日期或标题)自动重命名和分类归档。
4. 数据存储与导出模块:将抓取到的结构化数据实时存入本地数据库(或生成CSV/Excel文件),方便后续进行数据清洗与业务分析。
负责任务:我独立负责了该项目的需求分析、架构设计、核心代码编写及后期测试调优。
技术栈:主要采用 Python (Requests/Scrapy + BeautifulSoup) 进行核心逻辑开发,针对动态渲染页面引入 Selenium/Playwright;若采用 Java 方案,则基于 Jsoup + HttpClient 实现。数据存储使用 MySQL/本地文件。
实现亮点与难点:
1. 难点(反爬应对):目标网站存在请求频率限制和动态加载。我通过封装随机代理IP池、请求头伪装、以及引入无头浏览器模拟真人操作,成功绕过了网站的基础反爬限制。
2. 亮点(下载稳定性):针对附件下载时常因网络波动中断的问题,我设计了多线程异步下载与断点续传/失败重试机制,极大地提升了附件下载的成功率和整体采集效率,保障了工具在 Windows 环境下长期稳定运行。

评论