

做课程和口播视频的人,最烦的不是剪,是打字。一条十五分钟的视频,靠听打要一个半小时,还容易听错人名和专业词。外包给字幕组,一条几十块,来回对稿又要等一天,赶发布的时候就卡在这一步。


点击空白处退出提示



做课程和口播视频的人,最烦的不是剪,是打字。一条十五分钟的视频,靠听打要一个半小时,还容易听错人名和专业词。外包给字幕组,一条几十块,来回对稿又要等一天,赶发布的时候就卡在这一步。
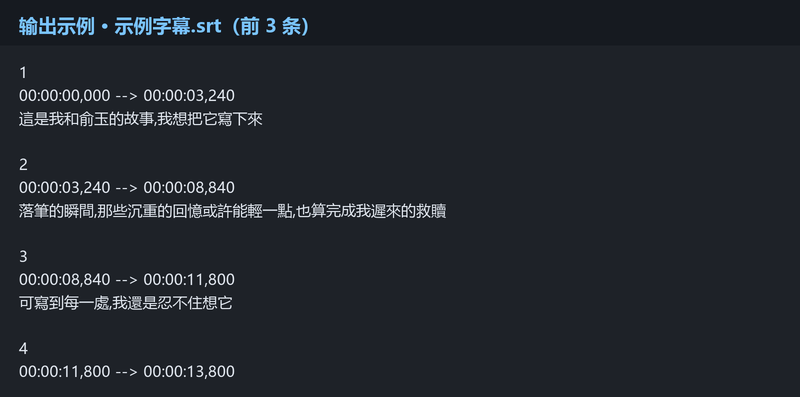
导入一个视频或音频,自动分离音轨并统一采样率,用本地模型识别成文字,再按语义重新切句、压到每行不超过二十来个字,导出 srt。可以一次丢多个文件进队列,输出文件名跟源文件对应,剪映、PR 直接导入就能用。不联网,素材不外传。
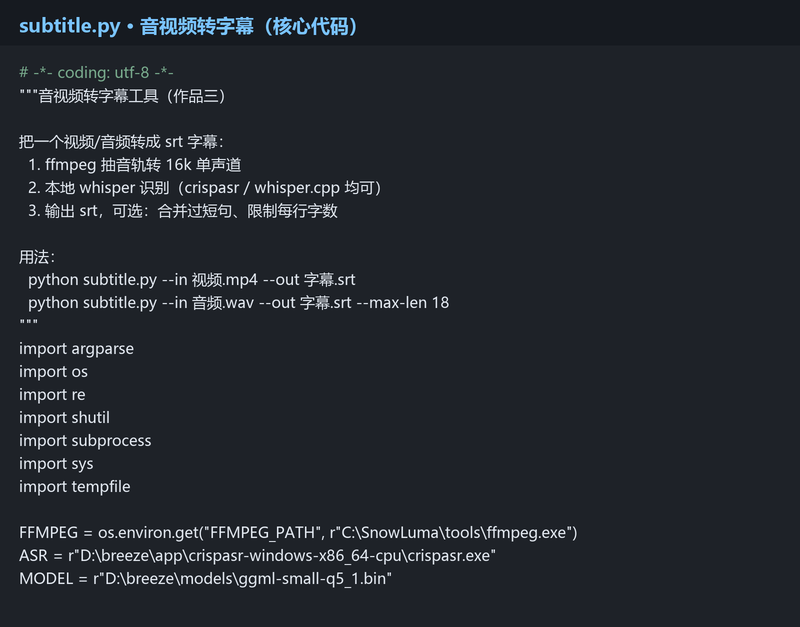
音轨用 ffmpeg 抽出来并重采样成 16k 单声道,避免识别端采样率不匹配。识别跑本地 whisper.cpp 模型,输出原始 srt 后做二次处理:按中文标点重新断句、限制单行长度、时间轴按新句子重排。批量时逐个文件处理,失败单独记日志不中断队列。

评论