中文母语水平
英语可口语交流
日语无工具书面交流
0
1
2
3
4
5
 大模型算法
 深圳
多模态算法工程师,主要从事视觉语言模型(VLM,能够同时理解图像/视频和文本的大模型)、视频理解、大模型微调与推理部署相关工作。
熟悉 Python、PyTorch、Qwen-VL、InternVL、vLLM 等技术栈,具备从数据处理、模型训练、效果评测到推理服务部署的完整项目经验。
可承接:多模态/大模型项目开发、模型微调、视频与图像理解、PyTorch 训练问题排查、vLLM 推理部署与性能优化、模型接口封装、Python 数据处理及自动化工具开发。
更擅长解决已有项目中的实际技术问题,例如模型跑不通、训练效果异常、显存占用过高、推理速度慢、多模态输入适配、模型服务部署等问题。
接受需求明确的短期远程项目和技术问题诊断,重视代码质量、可复现性和最终交付效果。
2024-08-30 -至今百度大模型算法
负责多模态大模型基座模型研发,数据飞轮,多模态模型后训练,多模态模型数据清洗处理,dpo,grpo,ppo,opd
2021-09-01 - 2024-06-15华东师范大学计算机技术硕士
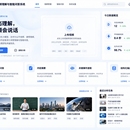
系统主要包含视频预处理、多模态模型推理、视频问答、内容摘要和结果展示等模块。支持用户上传本地视频,自动完成视频抽帧与视觉信息预处理,并调用视觉语言模型进行内容理解。用户可以针对视频提出自然语言问题,例如人物行为、事件过程、物体变化和时序关系等,系统根据视频内容生成回答。同时支持生成视频摘要和关键事件
 0