

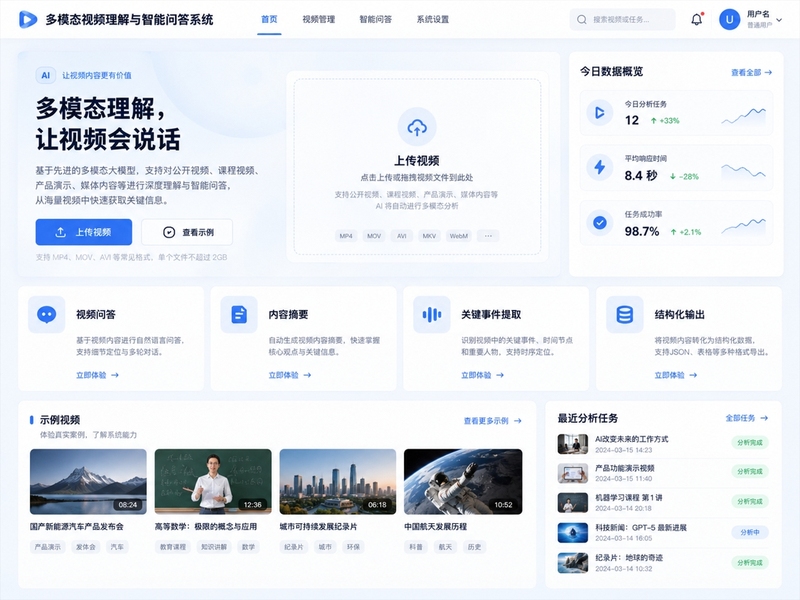
面向视频内容理解和智能分析场景,针对传统视频处理需要人工逐段查看、检索效率低的问题,构建基于多模态大模型的视频理解系统。用户上传视频后,系统可自动解析关键视觉内容,并通过自然语言完成视频问答、内容摘要和关键信息提取,适用于公开课程视频、产品演示、媒体内容等通用场景。


点击空白处退出提示



面向视频内容理解和智能分析场景,针对传统视频处理需要人工逐段查看、检索效率低的问题,构建基于多模态大模型的视频理解系统。用户上传视频后,系统可自动解析关键视觉内容,并通过自然语言完成视频问答、内容摘要和关键信息提取,适用于公开课程视频、产品演示、媒体内容等通用场景。
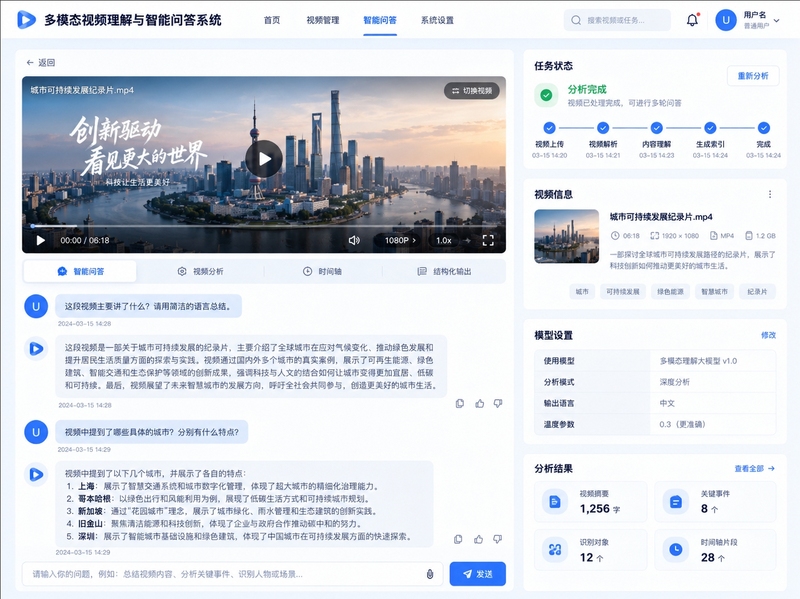
系统主要包含视频预处理、多模态模型推理、视频问答、内容摘要和结果展示等模块。支持用户上传本地视频,自动完成视频抽帧与视觉信息预处理,并调用视觉语言模型进行内容理解。用户可以针对视频提出自然语言问题,例如人物行为、事件过程、物体变化和时序关系等,系统根据视频内容生成回答。同时支持生成视频摘要和关键事件描述,并提供统一的接口服务,便于后续接入其他应用。
本项目主要负责整体算法与服务端实现。使用 Python 和 PyTorch 完成视频抽帧、数据预处理及多模态模型推理流程,采用开源视觉语言模型处理图像与视频输入,并通过 vLLM 进行推理服务部署与性能优化。服务层使用 FastAPI 封装统一接口,实现视频上传、任务管理和模型调用。针对长视频输入,对采样帧数量、图像分辨率和上下文长度进行控制,在显存占用、推理速度与视频信息完整度之间进行权衡。同时增加异常处理、推理日志和结果结构化输出,方便模型问题定位及后续系统集成。

评论