


中文母语水平
英语无工具书面交流
0
1
2
3
4
5
 python数据开发工程师
 合肥
本人毕业于成都东软学院网络工程专业,长期从事 Python 开发、数据采集、数据处理及 Web 系统开发,具备较完整的项目开发和实际业务落地经验。
曾参与全国招投标信息数据采集平台建设,基于 Python + Scrapy 开发和维护大规模数据采集任务,覆盖全国政府采购、公共资源交易中心、招投标平台及行业网站约 3000 个数据源。参与分布式采集架构、任务调度、数据清洗、去重、标准化、异常恢复及长期运行维护,对大规模、多站点数据采集场景具有较丰富经验。
熟悉 Python、Scrapy、Redis、MySQL、Linux、Docker 等技术,可独立完成从需求分析、数据源分析、程序开发、数据处理到部署维护的完整流程。同时可承接数据分析、自动化脚本、API 接口、后台管理系统及网站开发等需求。
目前主要承接以下方向的项目:公开数据采集、Python 自动化、数据清洗分析、接口开发、网站及后台系统开发。注重代码质量、稳定性和实际交付效果,能够根据业务需求提供合理的技术方案,并支持后续维护与优化。
仅承接合法合规的开发及公开数据采集项目。
如果你想让这份介绍更偏“接单成交”,最后一段还可以换成:
如果您有 Python 开发、公开网页数据采集、数据整理分析、自动化工具、API 接口或网站系统开发需求,欢迎沟通。可根据需求先评估技术方案、开发周期及工作量,确认后再进行开发
2021-04-01 -至今数智建造研究院python数据开发工程师
主要负责 Python 数据采集、数据处理及相关系统开发工作,参与全国招投标信息数据采集平台的建设与维护。 项目采用 Python + Scrapy 技术体系,对全国政府采购、公共资源交易中心、招投标平台及行业网站等公开数据源进行自动化采集,累计涉及约 3000 个网站。参与分布式采集架构设计与任务管理,实现多站点、多任务并行运行,提高大规模数据采集效率及系统稳定性。 主要工作包括: 根据不同网站结构开发和维护 Scrapy 爬虫,完成列表页、详情页、分页及多层级页面的数据解析与采集; 参与约 3000 个招投标网站的采集规则开发、维护及异常排查; 参与分布式任务管理,实现采集任务分配、调度、运行状态管理及异常任务处理; 对采集数据进行字段提取、清洗、去重、格式标准化及结构化处理; 处理网站改版、页面结构变化、网络异常、任务失败等问题,提高采集程序长期运行的稳定性; 根据业务需求持续新增数据源、优化采集逻辑及采集效率; 配合数据分析及业务部门完成招标公告、中标公告、采购信息、变更公告等数据的整理与应用。 通过该项目积累了大规模多站点数据采集、Scrapy 爬虫开发、分布式任务管
2011-09-01 - 2015-07-23成都东软学院网络工程本科
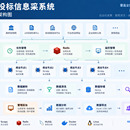
项目主要实现全国招投标网站数据自动化采集及管理。核心功能包括:1.多站点数据采集支持全国约3000个招投标网站数据采集,包括公告信息、中标信息、采购信息等。2.分布式爬虫管理基于Scrapy框架搭建分布式采集架构,实现任务调度、任务分发和多节点并行采集,提高采集效率。3.数据清洗处理对采集后的网页数
 0
运维开发工程师
500元/天
沈阳艾尔时代科技有限公司
技能:Vue.js,Python,Docker,Django,ElasticSearch
技术总监
800元/天
临沂慧泽信息技术有限公司
技能:APICloud,C#,Python,Django,Redis,CSS,JavaScript,jQuery,MySQL,MongoDB
高级后端工程师
800元/天
veeva
技能:Java,Django,Python,Docker,AWS,ELK,Jenkins,uWSGI,docker swarm,Spring cloud
全栈工程师
300元/天
无
技能:html,CSS,JavaScript,Python,Vue,小程序,uniapp

