

随着企业招投标业务的发展,企业需要及时获取全国各地区招投标公告、采购信息、中标信息等数据。传统人工查询效率低,数据来源分散,无法满足企业对实时数据采集和分析的需求。
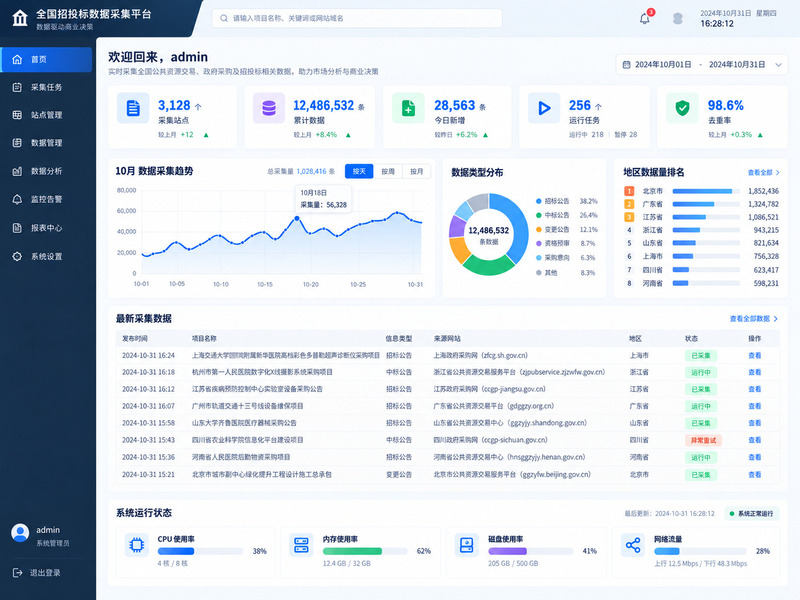
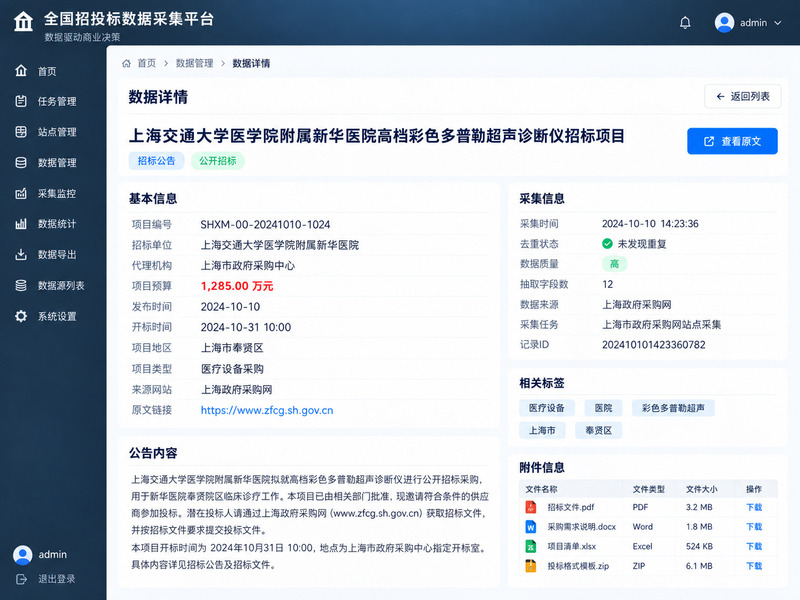
本项目针对全国招投标网站数据采集需求,建设分布式数据采集系统,实现多网站、多来源招投标信息自动化抓取、清洗、存储及管理,为企业数据分析和业务决策提供数据支持。


点击空白处退出提示



随着企业招投标业务的发展,企业需要及时获取全国各地区招投标公告、采购信息、中标信息等数据。传统人工查询效率低,数据来源分散,无法满足企业对实时数据采集和分析的需求。
本项目针对全国招投标网站数据采集需求,建设分布式数据采集系统,实现多网站、多来源招投标信息自动化抓取、清洗、存储及管理,为企业数据分析和业务决策提供数据支持。
项目主要实现全国招投标网站数据自动化采集及管理。
核心功能包括:
1. 多站点数据采集
支持全国约3000个招投标网站数据采集,包括公告信息、中标信息、采购信息等。
2. 分布式爬虫管理
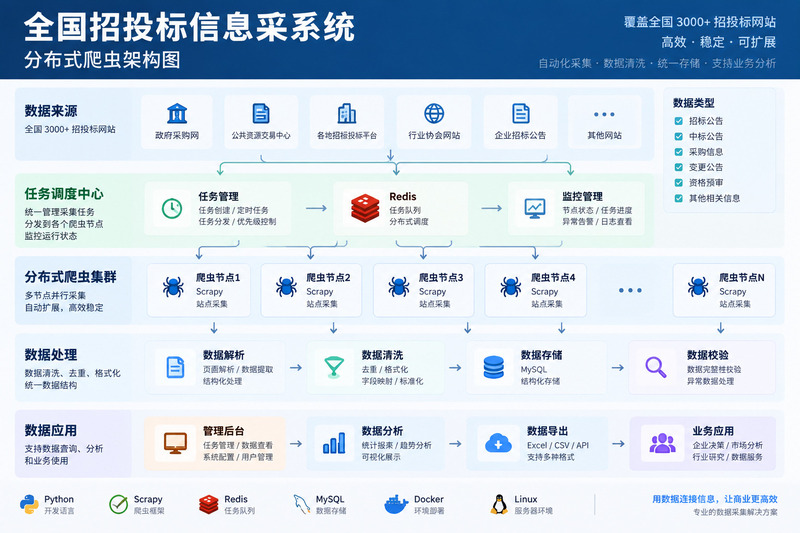
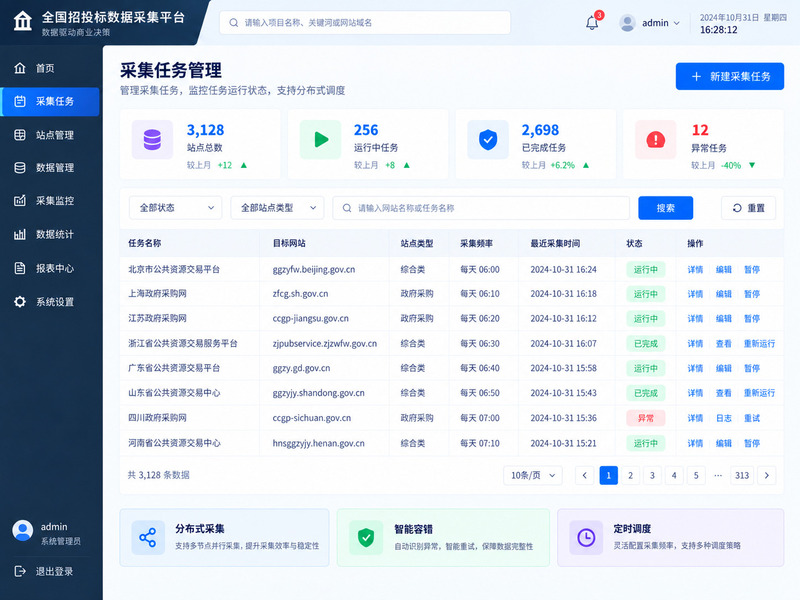
基于Scrapy框架搭建分布式采集架构,实现任务调度、任务分发和多节点并行采集,提高采集效率。
3. 数据清洗处理
对采集后的网页数据进行解析、去重、格式化处理,统一数据结构。
4. 数据存储管理
支持结构化数据存储,方便后续查询、分析和业务调用。
5. 任务监控管理
实现爬虫运行状态监控、异常处理以及采集任务管理。
项目采用Python作为主要开发语言,基于Scrapy框架实现爬虫核心功能。
技术架构:
Python + Scrapy + Redis + MySQL + Linux
通过Scrapy实现网页解析、数据提取和采集流程管理,结合Redis实现分布式任务调度,多台服务器协同运行,提高大规模网站采集能力。
项目针对不同网站结构设计独立解析规则,通过数据清洗模块统一处理不同来源的数据格式。
项目难点:
1. 全国不同网站页面结构差异较大,需要针对不同站点设计解析策略。
2. 采集规模达到3000+网站,需要解决任务调度、稳定运行和异常恢复问题。
3. 对采集数据进行去重、清洗和标准化,提高数据可用性。

评论