




项目背景:基于淘宝公开订单数据集(99,457 行 × 9 列、39 个月)从零搭建离线数仓,为报表与自助分析提供统一口径销售指标 |
▪ 分层建模与 ETL:ODS→DWD→DWM→DWS→DM 五层 + dim;针对尾逗号、日期混乱、浮点噪声(16% 行受影响)等脏
数据,DWD 八步清洗(去重、缺失值、异常过滤、round 修约),各层与 ODS 行数对账一致;明细层改 ORC 列存
6.07MB→1.39MB(压至 23%)。
▪ 指标计算与 SQL 优化:针对 Hive on MR 清洗耗时约 7 分钟的问题,用 PySpark DataFrame 复刻同一清洗压到 1.5 秒(约
280 倍);DM 层报表直供(华为命名规范),COUNT(DISTINCT) 回明细重算保证口径正确。
▪ 维度建模:星型双维表(代理键 ROW_NUMBER、派生年龄段 CASE WHEN),三表 JOIN 产出「50+ 人群 × Clothing 贡献
3704 万元」,推翻年轻人是消费主力的直觉假设。
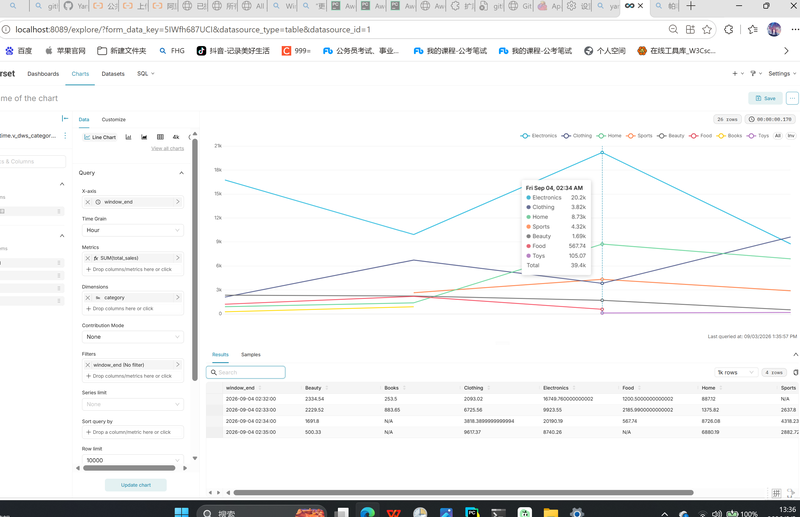
▪ 可视化与调度:Superset 拖拽看板 + PyHive/pyecharts HTML 报表双路线,挂任务计划程序每日产出(日期戳防覆盖)。
成果:统一销售指标口径,T+1 产出 39 个月 × 8 品类指标,支撑业务自助分析;清洗规则与对账流程成文可复用。



点击空白处退出提示
评论