

集群服务需要统一且细致的运行监控,对集群中各服务器的运行情况,包括硬件参数,存储容量,服务内部在线及资源占用,数据库运行情况,业务服务运行情况等进行可视化的展示。实现运行情况可追溯,实现服务异常的实时告警。保证服务运行稳定,出现异常能第一时间获悉并处理,避免生产事故发生。同时可以提供运行数据的有力支撑,将一切数据可视化。


点击空白处退出提示



集群服务需要统一且细致的运行监控,对集群中各服务器的运行情况,包括硬件参数,存储容量,服务内部在线及资源占用,数据库运行情况,业务服务运行情况等进行可视化的展示。实现运行情况可追溯,实现服务异常的实时告警。保证服务运行稳定,出现异常能第一时间获悉并处理,避免生产事故发生。同时可以提供运行数据的有力支撑,将一切数据可视化。
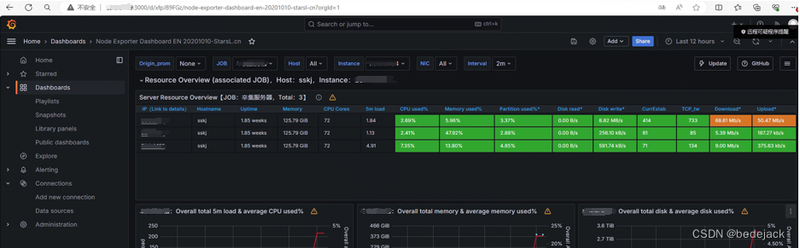
本服务主要基于prometheus的强大监控能力及海量监控插件实现落地,目前已有的导出器数量已超过 700 个,所有主流中间件及服务框架均在监控实施范围之内。结合grafana实现无代码运维数据web展示,alertmanager低代码告警实时推送。
可监控jvm,nginx,各linux服务器系统,windows server服务器系统监控,各种数据库监控,docker及k8s等虚拟容器监控。
实现微信,邮件,短信等多渠道实时告警信息推送。
服务器集群包括12台分布式服务器,包括两台云服务器和十台物理机房服务器。由于甲方要求,在事态物理服务器中的两台均进行了prometheus主体部署,同步部署了grafana无代码web服务及alertmanager告警组件。十台物理服务器为ubuntu系统,数据库为mysql主备,另外redis采用三节点模式。另外云服务器为麒麟系统。
1.全部linux服务器部署node监控系统软硬件运行情况,包括cpu占用,内存试用,磁盘空间等。
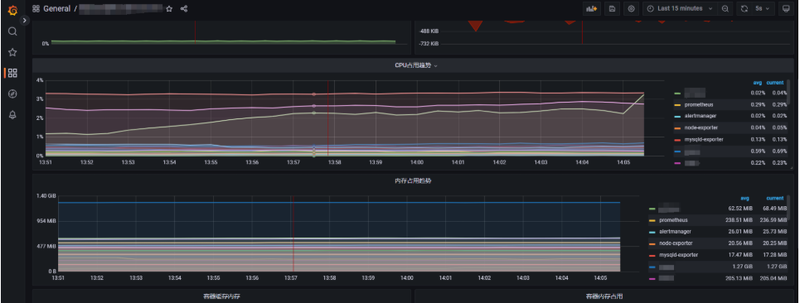
2.docker部署监控组件,监控镜像运行情况及各镜像资源试用情况。
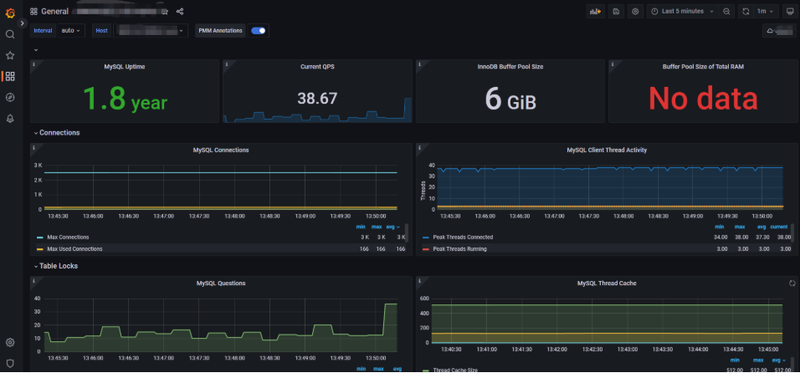
3.数据库部署监控组件,监控数据库语句运行情况。
4.部署prometheus监控数据接收,部署grafana展示服务。编写grafana配置展示页效果。
5.部署alertmanager告警组件,配置微信及电子邮件告警推送服务。

评论