

大量中小企业存在「重复性数据处理」的痛点:数据分散在网页或几十个 Excel 里,靠人工逐条复制整理,耗时长、易出错,且无法持续更新。
本项目的立项原因,是用程序把这类规则明确的重复劳动自动化——同样一批数据,人工需要数小时,程序几分钟即可完成,且零误差、可复现、可按天自动更新。
旨在解决数据获取与整理的「效率、准确性、持续性」三个问题,让企业把人力从机械劳动中释放出来,直接获得可用于分析和决策的规范数据

点击空白处退出提示
大量中小企业存在「重复性数据处理」的痛点:数据分散在网页或几十个 Excel 里,靠人工逐条复制整理,耗时长、易出错,且无法持续更新。
本项目的立项原因,是用程序把这类规则明确的重复劳动自动化——同样一批数据,人工需要数小时,程序几分钟即可完成,且零误差、可复现、可按天自动更新。
旨在解决数据获取与整理的「效率、准确性、持续性」三个问题,让企业把人力从机械劳动中释放出来,直接获得可用于分析和决策的规范数据
Python 数据采集与办公自动化
主攻 Python 方向的数据采集与办公自动化,可承接中小体量的数据类需求。
【我能做的】
1网页数据采集:静态页面抓取、分页批量抓取、数据去重校验、断点续爬(中断后可继续,不用从头跑)
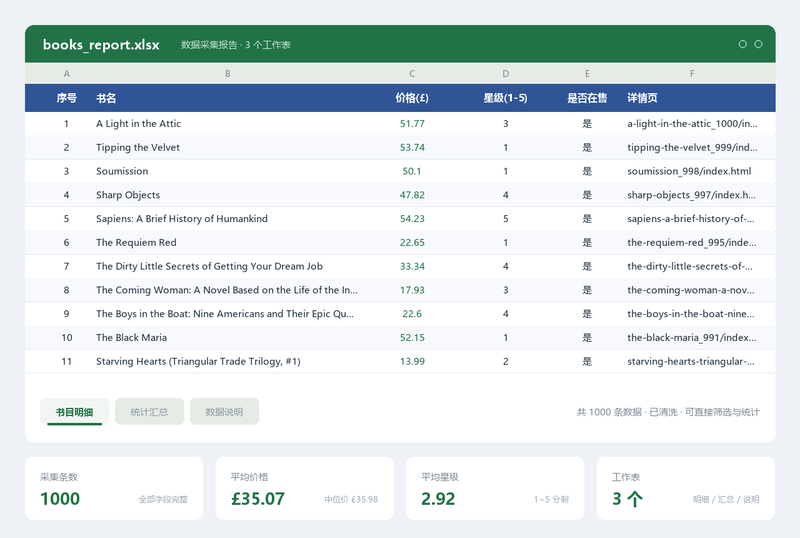
2 数据清洗与交付:价格/日期/单位标准化,异常值与缺失值检测,输出 Excel 报表(含明细表 + 统计汇总表 + 数据字典)
3 办公自动化:批量处理 Excel/CSV,按规则拆分合并表格,批量重命名与文件归档
4接口数据对接:对接公开 JSON 接口获取数据(比解析网页更快、更稳定)
5 定期更新:可配置定时任务,每天/每周自动运行并输出最新数据
【我的交付习惯】
代码带独立配置文件,参数可自行调整,不用改代码
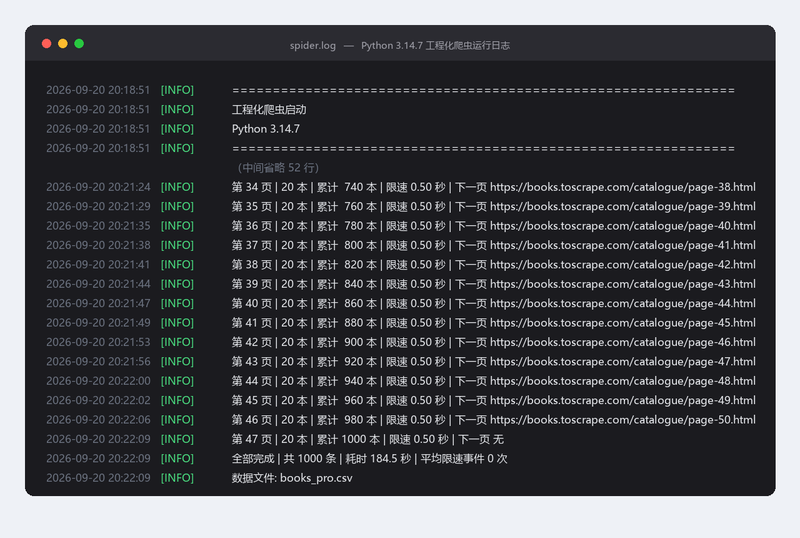
带完整运行日志,出问题能快速定位
交付物附数据字典,说明每个字段的含义、单位与数据来源
先小范围试跑验证效果,确认无误后再全量执行
【适合的场景】
中小体量的数据采集、企业内部重复性数据处理、公开数据的定期监控与报表输出。
【合作说明】
沟通及时、响应快,重视交付质量。首次合作可先做小范围验证,满意后再继续。
我负责的工作
1. 需求与目标站点调研:分析 robots.txt、页面 DOM 结构、分页规律,确定采集范围与合规边界
2. 采集模块开发:实现分页遍历、链接解析、请求限速、自动重试、代理池轮换
3. 反爬策略设计:User-Agent 伪装、自适应限速(被限流自动降速)、失败退避重试
4. 数据清洗模块:价格与评分类型标准化、缺失值/重复项检测、数据质量问题主动上报
5. 交付物设计:Excel 三工作表输出(明细表 / 统计汇总 / 字段说明),含冻结表头与自动筛选
6. 工程化改造:参数外置为配置文件、全流程日志记录、断点续爬状态管理
7. 部署方案:编写定时任务方案,支持按天自动更新数据
技术栈
· 开发语言:Python 3.14
· 网络请求:requests、requests.Session、urllib3(Retry 重试策略 / HTTPAdapter)
· 网页解析:BeautifulSoup4(html.parser)、urllib.parse.urljoin
· 数据处理:re(正则提取)、statistics(统计)、collections.Counter(频次统计)
· 数据存储:CSV(utf-8-sig)、openpyxl(Excel 多工作表与格式控制)
· 工程化:logging(日志)、json(外部配置与状态持久化)、pathlib(跨平台路径)
· 部署运维:Windows 任务计划程序 / Linux crontab 定时调度

评论