

一个“影视口碑数据聚合与分析工具”,而非简单的爬虫脚本集合。它的目标用户是三类人群:一是影视内容研究者,需要批量获取历史评分数据做趋势分析;二是影视投资与发行决策者,需要在映前判断题材热度与受众预期;三是深度影迷,希望跳出单一评分数字,看到评分分布、评价人数增长曲线、关键词云等结构化信息,辅助自己的观影判断。

点击空白处退出提示
语言技术
Python、JavaScript系统类型
Windows行业分类
企业服务
一个“影视口碑数据聚合与分析工具”,而非简单的爬虫脚本集合。它的目标用户是三类人群:一是影视内容研究者,需要批量获取历史评分数据做趋势分析;二是影视投资与发行决策者,需要在映前判断题材热度与受众预期;三是深度影迷,希望跳出单一评分数字,看到评分分布、评价人数增长曲线、关键词云等结构化信息,辅助自己的观影判断。
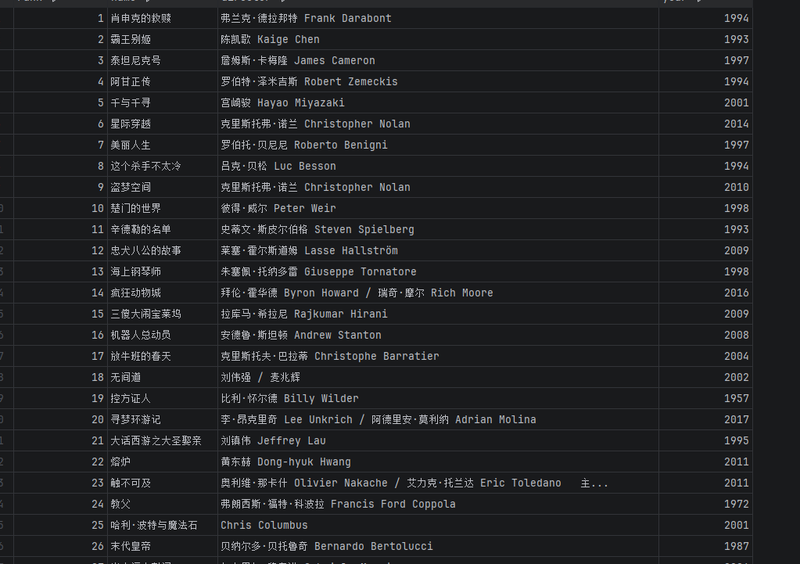
豆瓣电影Top250等榜单长期被视为影迷“入门片单”,但仅看排名和分数远远不够。内容策划方需要回答更细的问题:高分剧情片的平均片长趋势是怎样的?不同年代“神作”的类型标签重叠度有多高?哪些导演的作品评分方差最小(意味着质量稳定性)?这些分析依赖结构化字段的批量采集与清洗,正是爬虫程序的核心价值所在。
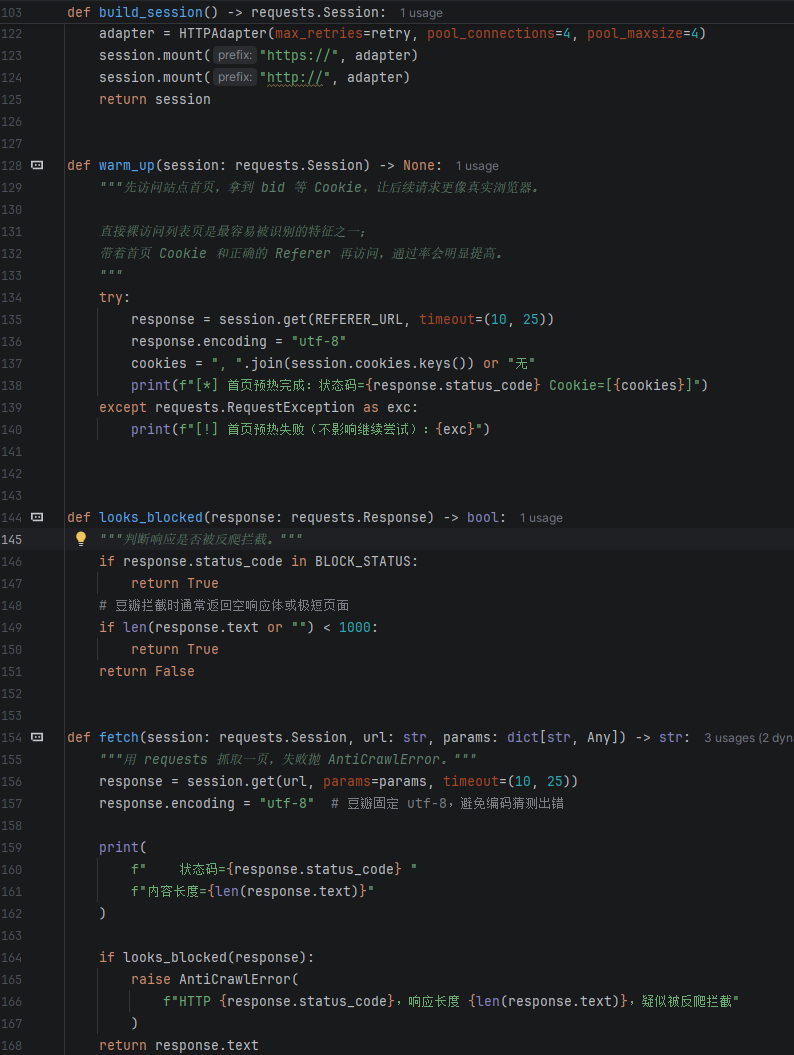
豆瓣的反爬体系是动态多层次的:基础身份验证(User-Agent/请求头)、访问频率与IP限制、登录态与Cookie绑定。单机Requests脚本在爬取超过数百个页面后大概率触发403封锁。因此,本产品的业务可行性不在于“写一个能跑的爬虫”,而在于在合规边界内设计可持续的数据采集管道:User-Agent轮换、请求间隔随机化(1.5-3.5秒)、代理池接入、以及必要的增量去重策略。这些工程约束本身构成了产品的护城河——个人脚本难以维护的,恰恰是产品化爬虫的交付价值。

评论