

独立开发者与「一人公司」经营者需要持续跟踪同行的案例复盘、可复用的方法与工具、新出现的机会需求以及行业动态。这些信息分散在 Reddit、Hacker News、Google News、少数派、V2EX 等中英文站点,逐个人工浏览成本极高,而且内容池里混杂大量卖课、加盟、拉人头的营销内容。本项目立项目标是做一条高信噪比的信息流,只保留与「一个人如何经营一家公司」真正相关的条目。

点击空白处退出提示
独立开发者与「一人公司」经营者需要持续跟踪同行的案例复盘、可复用的方法与工具、新出现的机会需求以及行业动态。这些信息分散在 Reddit、Hacker News、Google News、少数派、V2EX 等中英文站点,逐个人工浏览成本极高,而且内容池里混杂大量卖课、加盟、拉人头的营销内容。本项目立项目标是做一条高信噪比的信息流,只保留与「一个人如何经营一家公司」真正相关的条目。
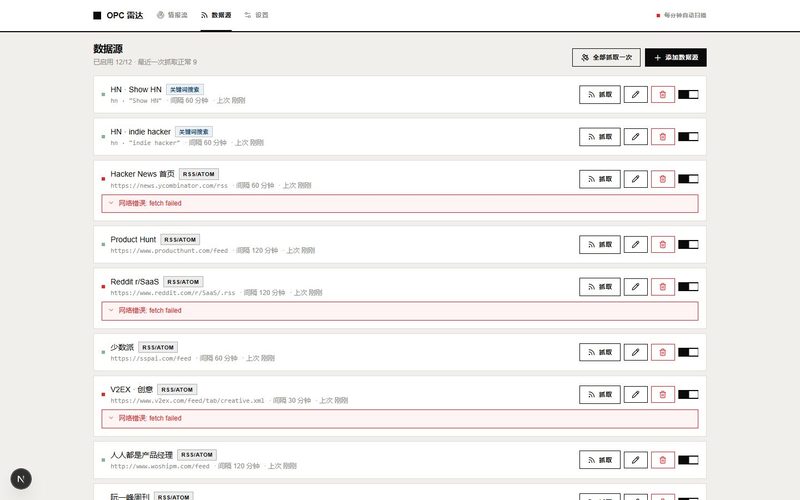
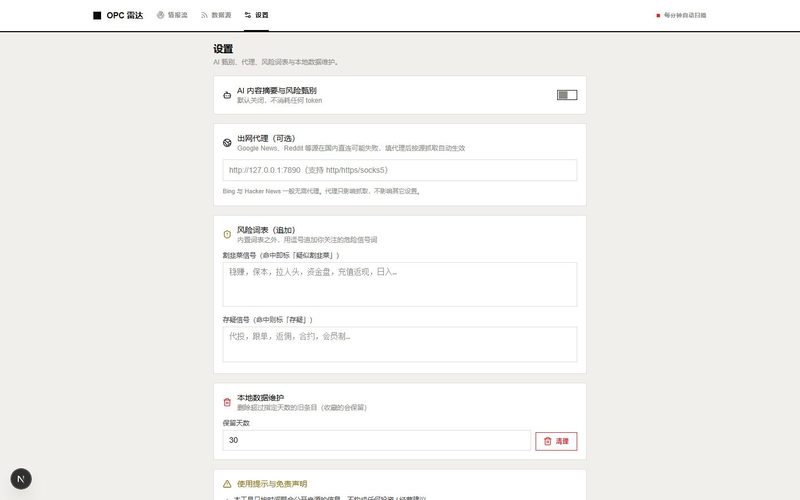
1、多源聚合:接入 12 个中英文数据源并定时抓取入库,支持按源启停管理。2、自动分类:规则引擎把内容归入「案例复盘 / 方法工具 / 机会需求 / 行业动态」四类。3、相关性闸门:未命中任一分类关键词的条目在入库阶段即被过滤,保证信噪比,不做「其他」垃圾桶。4、割韭菜识别:对卖课、加盟、拉人头类话术做标记,只标记不隐藏,把判断权留给使用者。5、三个页面:情报流、数据源管理、设置(模型、代理、关键词表、数据清理)。
独立完成全栈开发。技术栈 Next.js 16 + React 19 + Tailwind CSS v4 + TypeScript,存储使用本地 SQL 数据库,抓取解析使用 fast-xml-parser 与 cheerio,定时任务由 node-cron 在应用启动时注册。亮点:① 分类与过滤在入库环节完成而非展示层过滤,数据库里不存在噪声数据;② 关键词表与分类规则集中在独立模块,调整分类策略不需要改动抓取逻辑;③ 实践中验证并剔除了一批失效源(返回 HTML 而非 XML 的站点、已被营销内容污染的搜索接口),并针对限流源调整抓取间隔。


评论