

电商数据分析 / 竞品价格监控 / 舆情监测与数据分析 / 金融数据采集/企业采集内容

点击空白处退出提示
电商数据分析 / 竞品价格监控 / 舆情监测与数据分析 / 金融数据采集/企业采集内容
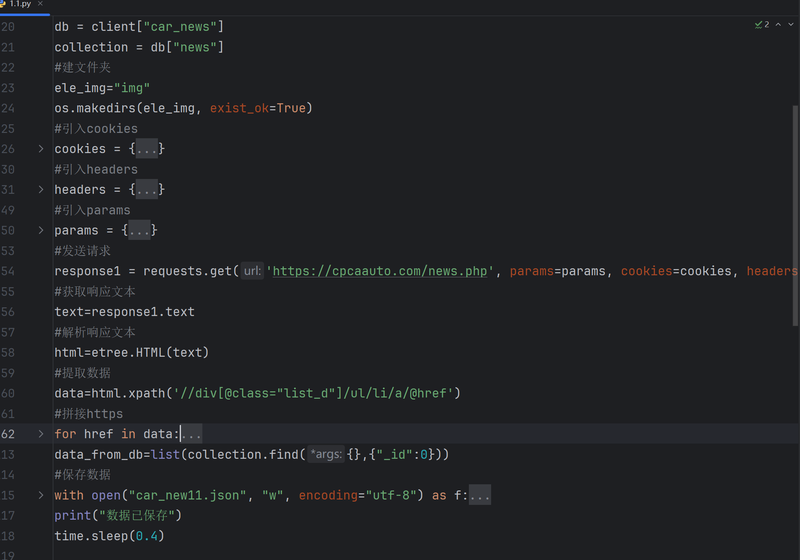
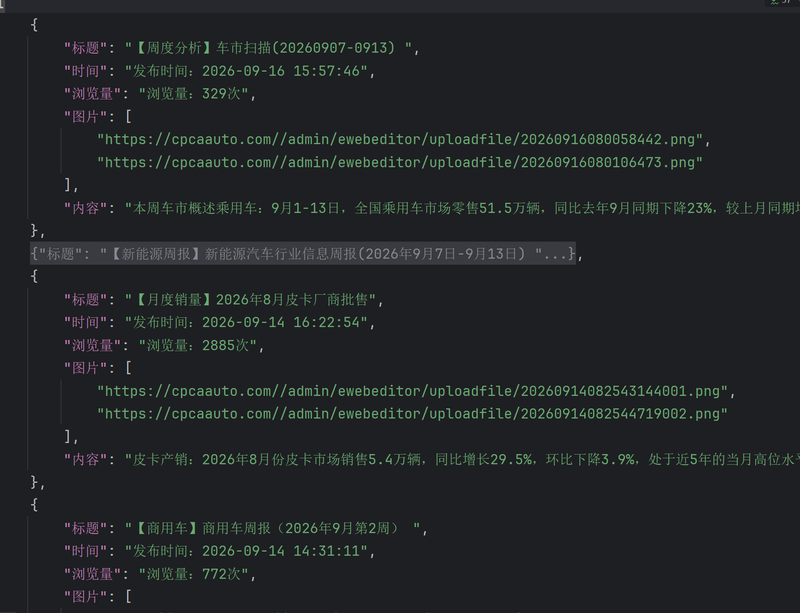
通过输入关键词或目标URL,自动抓取指定平台的公开数据(如商品名称、价格、销量、评论、发布时间等)。支持定时增量抓取和全量抓取,能够自动识别并绕过基础反爬机制(如Cookie校验、User-Agent限制),将抓取到的非结构化数据清洗后持久化存入MySQL/MongoDB数据库,最终通过Web端或报表形式展示数据趋势,并支持一键导出Excel/CSV文件,为用户提供数据决策支持。
负责整体爬虫架构设计、核心代码编写、反爬策略突破及数据清洗入库工作。
技术栈与架构:采用 Python + Scrapy-Redis 分布式架构,使用 Requests/Selenium 处理动态渲染页面,数据存储于 MySQL 和 Redis,通过 Docker 部署。

评论