

互联网网站在日常运营中,会持续产生海量用户访问行为日志。如果使用传统单机程序处理海量日志,会受限于单机内存、硬盘容量,存在处理速度慢、无法支撑TB级数据存储与计算的问题。
本项目面向互联网运营离线报表场景,用于定时统计网站每日用户访问总量。企业可以每日凌晨自动调度该Spark任务,读取存放在HDFS上的前一日用户访问原始日志,完成聚合计算,输出每日访问指标报表,供运营人员分析网站流量波动、评估推广效果,支撑网站运营决策。


点击空白处退出提示



互联网网站在日常运营中,会持续产生海量用户访问行为日志。如果使用传统单机程序处理海量日志,会受限于单机内存、硬盘容量,存在处理速度慢、无法支撑TB级数据存储与计算的问题。
本项目面向互联网运营离线报表场景,用于定时统计网站每日用户访问总量。企业可以每日凌晨自动调度该Spark任务,读取存放在HDFS上的前一日用户访问原始日志,完成聚合计算,输出每日访问指标报表,供运营人员分析网站流量波动、评估推广效果,支撑网站运营决策。
1. 数据源加载:支持加载模拟用户访问数据集;生产环境可读取HDFS中存储的海量日志文件,包含用户ID、访问日期、访问次数字段。
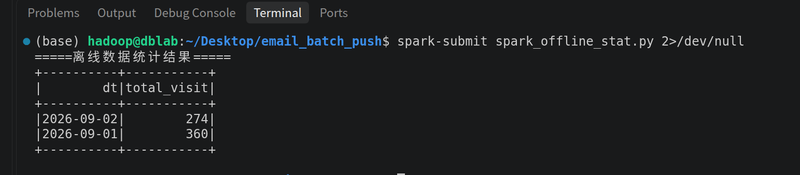
2. 离线聚合统计:基于Spark DataFrame按日期分组,对用户访问次数求和,自动计算每日网站总访问量,并对结果按日期排序。
3. 双模式运行:支持本地调试模式(不读写HDFS,快速验证代码逻辑)与分布式集群模式,可一键开启,将原始数据、统计结果持久化写入HDFS分布式文件系统。
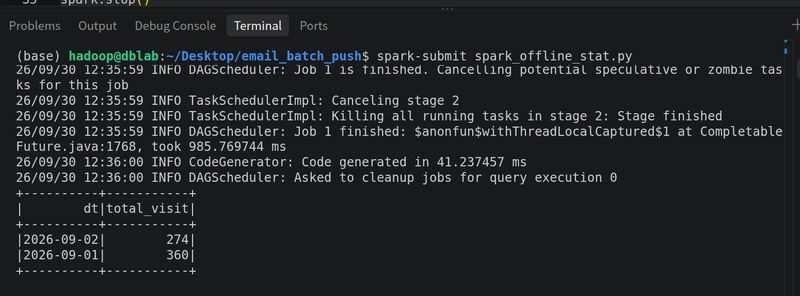
4. 结果输出:控制台打印结构化统计报表,直观展示每日流量指标;计算结果落地HDFS,可供后续BI可视化、报表查询使用。
5. 资源回收:任务执行结束自动关闭Spark会话,释放集群计算资源,避免内存占用。
独立完成需求设计、代码编写、调试与功能测试。
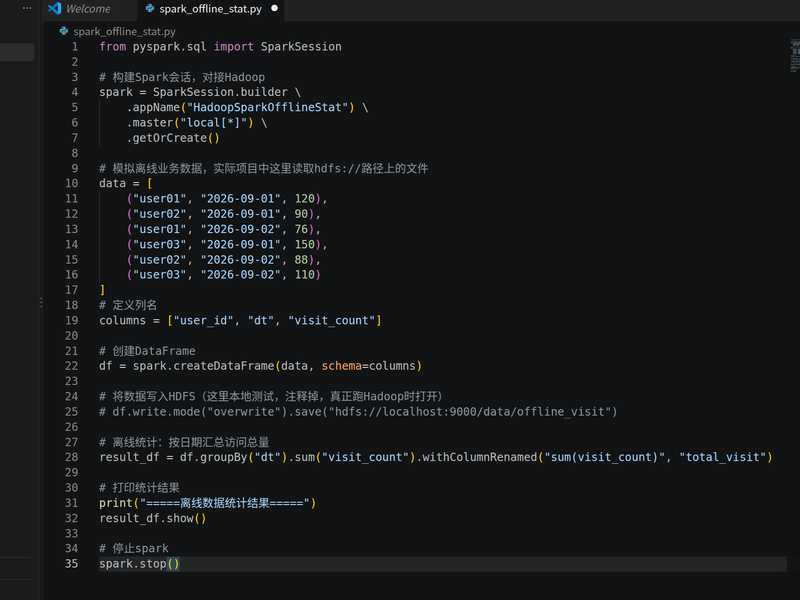
1. 使用SparkSession初始化Spark计算会话,连接Hadoop集群。
2. 构造模拟用户访问数据集,创建DataFrame结构化数据表,包含用户ID、访问日期、访问次数字段。
3. 采用groupBy分组聚合,sum函数统计每日全部用户访问总量,使用orderBy对日期排序,得到每日访问指标。
4. 支持将原始业务数据、离线统计结果写入HDFS分布式存储,mode="overwrite"覆盖旧数据,支持重复执行任务。
5. 任务执行完成后关闭Spark资源,释放集群内存。
项目亮点
1. 兼容两种运行模式:本地单机调试模式(无需读写HDFS)、Hadoop集群分布式模式,注释切换即可,开发调试便捷。
2. 使用Spark DataFrame API,代码可读性强,适合业务指标统计开发,贴合企业离线报表开发场景。
3. 支持海量数据扩展:模拟数据只是样例,真实场景可读取HDFS上的海量日志文件,分布式并行计算,突破单机性能瓶颈。
4. 数据落地:计算结果可以持久化到HDFS,后续可以对接可视化或者数据看板。
实现难点
1. Hadoop与Spark版本匹配问题,版本不一致会导致HDFS读写报错。
2. Hadoop需要预先启动dfs服务,端口9000需要保证可用,否则无法写入HDFS。
3. Spark资源管理:任务结束后必须stop释放资源,多次运行不释放会占用虚拟机内存。

评论