

自研项目面向公开讨论信息的研究与整理场景,解决动态网页数据难以稳定提取、记录重复、时间范围混杂以及分析结果缺少来源的问题。系统将网页标题和元数据转换为可查询的结构化记录,再按明确规则进行中文情感分析。本案例展示采集到分析的工程流程,属于自研展示项目。


点击空白处退出提示



自研项目面向公开讨论信息的研究与整理场景,解决动态网页数据难以稳定提取、记录重复、时间范围混杂以及分析结果缺少来源的问题。系统将网页标题和元数据转换为可查询的结构化记录,再按明确规则进行中文情感分析。本案例展示采集到分析的工程流程,属于自研展示项目。
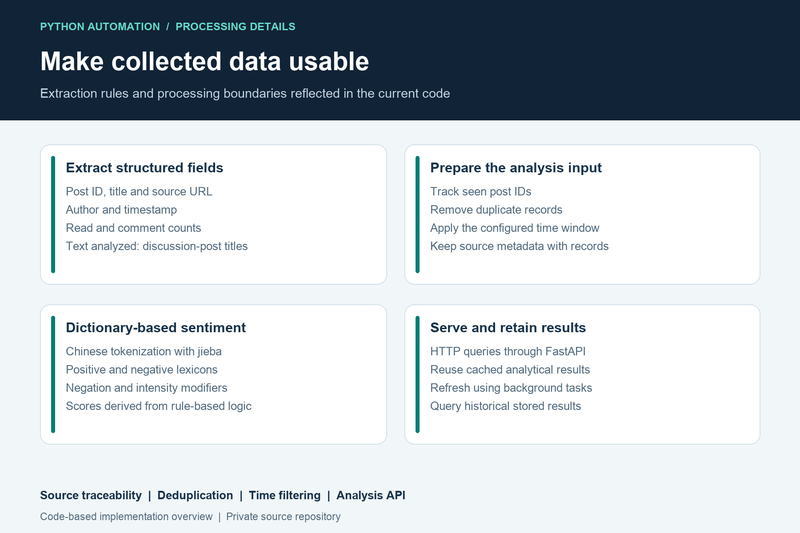
使用 Playwright 从动态渲染页面提取帖子标识、标题、来源链接、作者与时间等元数据,按帖子标识去重并应用时间窗口过滤。中文分析采用 jieba 分词、正负情感词典、否定词与程度词规则,对标题文本形成规则评分。FastAPI 提供查询和后台刷新入口,结合缓存与历史存储保留结果和来源信息。两张配图是依据代码制作的采集架构与处理流程图;当前文本输入为帖子标题,展示范围不包含训练完成的 FinBERT 模型或已测模型准确率。
我负责需求定义、数据字段与处理范围设计,指导实施、审阅代码与验收,开发使用 OpenAI Codex 进行 AI 辅助。项目采用 Python、Playwright、jieba、FastAPI 与异步 SQLAlchemy,重点处理动态页面字段抽取、重复记录、时间边界及来源追溯。介绍依据已有仓库和代码核查记录,配图展示实现结构。


评论