

立项原因:传统人工复制网页信息录入表格效率低下,容易出现录入错误,耗费大量人力时间。本工具旨在解决电商、企业市场调研中公开信息收集繁琐的问题。
行业场景业务背景:电商商家、企业市场人员经常需要收集竞品公开商品信息,用于市场分析,需要快速批量获取、整理网页公开数据并输出表格文件。


点击空白处退出提示



立项原因:传统人工复制网页信息录入表格效率低下,容易出现录入错误,耗费大量人力时间。本工具旨在解决电商、企业市场调研中公开信息收集繁琐的问题。
行业场景业务背景:电商商家、企业市场人员经常需要收集竞品公开商品信息,用于市场分析,需要快速批量获取、整理网页公开数据并输出表格文件。
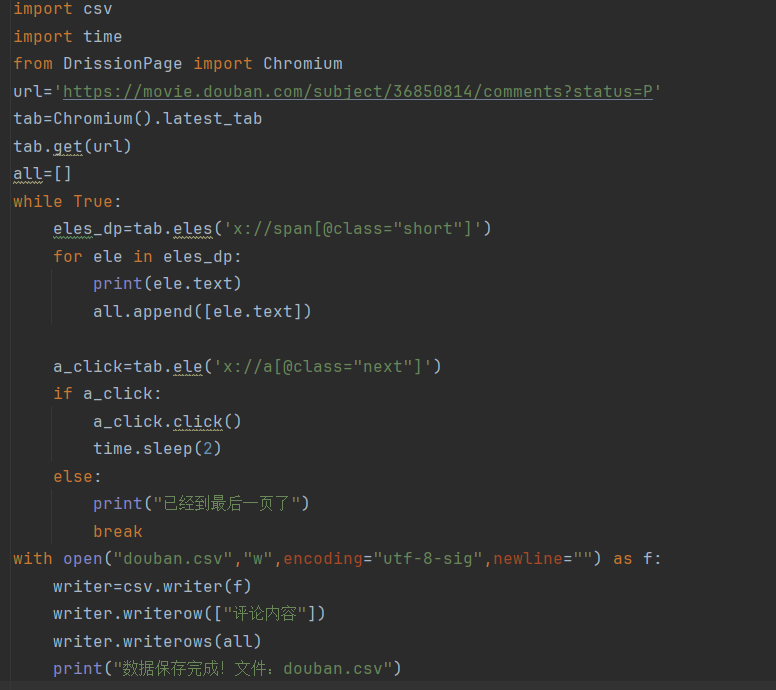
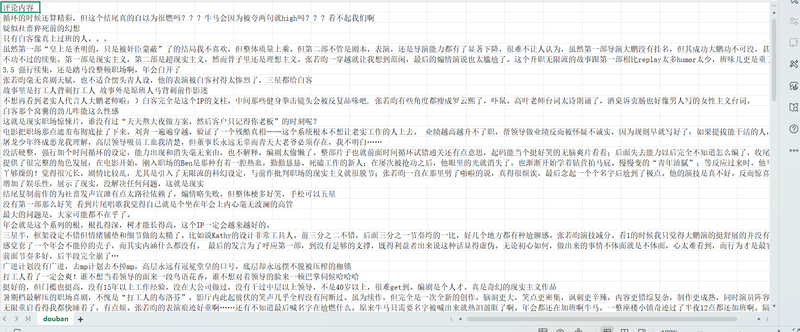
本项目为Python数据采集自动化工具,包含网页数据批量抓取、数据清洗、表格导出等核心模块。可自定义采集目标页面与字段,自动提取网页公开文本内容,对采集到的数据做去重、格式规整处理,支持将处理完成的数据导出为CSV文件。可根据客户需求调整采集规则,减少人工复制录入,高效完成电商、市场调研类信息收集工作。
我独立负责需求分析、脚本编写、功能调试全流程任务。项目使用Python开发,依托DrissionPage实现网页内容获取,借助csv库完成数据存储。实现亮点是轻量化本地运行,适配Windows系统;难点是应对网页页面结构差异,优化解析规则保证数据稳定提取。

评论