

本项目旨在解决批量获取音乐公开数据的难题。以往手动逐页复制歌曲榜单信息效率低、易出错,面向音乐内容运营与数据分析场景,为歌曲热度分析、歌单整理、选曲参考提供结构化数据基础,减少人工重复劳动。


点击空白处退出提示



本项目旨在解决批量获取音乐公开数据的难题。以往手动逐页复制歌曲榜单信息效率低、易出错,面向音乐内容运营与数据分析场景,为歌曲热度分析、歌单整理、选曲参考提供结构化数据基础,减少人工重复劳动。
1、关键词搜索:调用 QQ 音乐公开接口,按歌手或歌名返回歌名、歌手、专辑、时长、发行日期等字段;
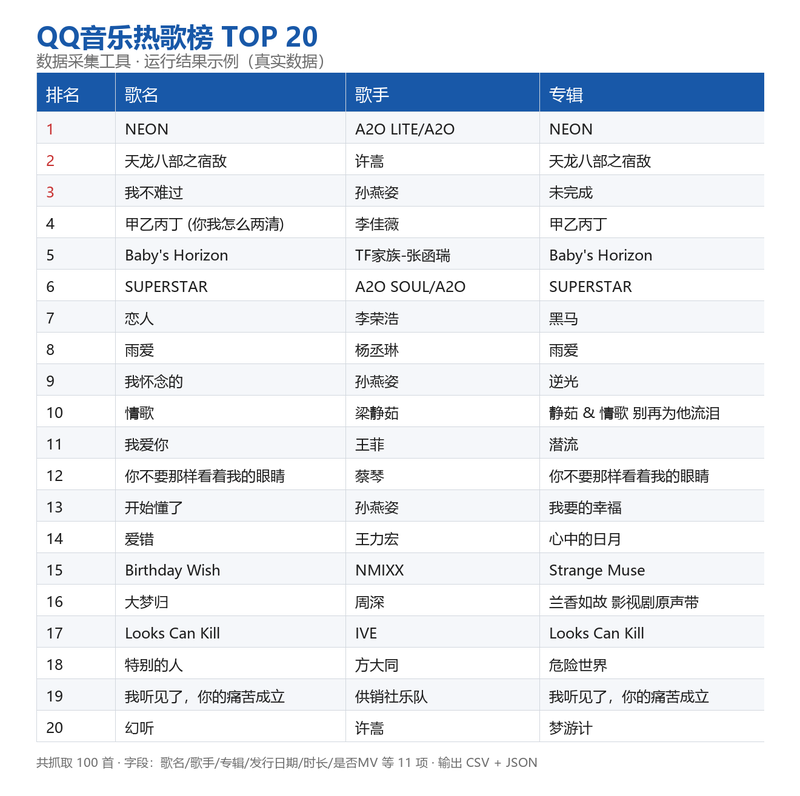
2、榜单批量抓取:一键抓取热歌榜、新歌榜等十余个榜单,自动翻页、去重、容错;
3、自动保存:结果同时输出 CSV 与 JSON,CSV 可直接用 Excel 打开,中文不乱码;
4、请求保护:内置随机延时、超时重试与用户代理,降低请求被封风险
我负责该爬虫工具的需求分析、架构设计与全部代码实现。技术栈采用 Python 3.12 + requests + BeautifulSoup4,使用 requests.Session 复用连接,BeautifulSoup 解析页面;实现亮点包括:自动翻页与去重、随机延时与超时重试降低被封风险、编码自动识别避免中文乱码、结果一键导出 CSV(带 BOM,Excel 直接打开不乱码)与 JSON 双格式。难点是适配目标站点不同页面的结构差异与请求频率限制,通过统一解析函数与指数退避重试解决。


评论