

大模型推理在长文档、代码库和持续对话场景下会产生巨大的 KV Cache,GPU 显存只能容纳其中一小部分;超出后只能排队、丢弃前缀缓存或重复 prefill,首 token 延迟和算力成本急剧上升。项目面向 GLM-5.3-Flash 的 MLA+Mamba 混合架构,在显存不变的前提下用内存和 SSD 扩展 KV 容量,让长上下文服务保持可用。


点击空白处退出提示



大模型推理在长文档、代码库和持续对话场景下会产生巨大的 KV Cache,GPU 显存只能容纳其中一小部分;超出后只能排队、丢弃前缀缓存或重复 prefill,首 token 延迟和算力成本急剧上升。项目面向 GLM-5.3-Flash 的 MLA+Mamba 混合架构,在显存不变的前提下用内存和 SSD 扩展 KV 容量,让长上下文服务保持可用。
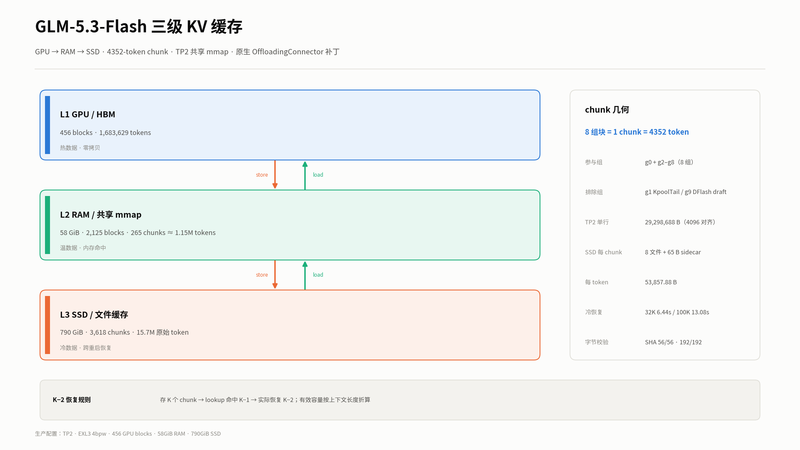
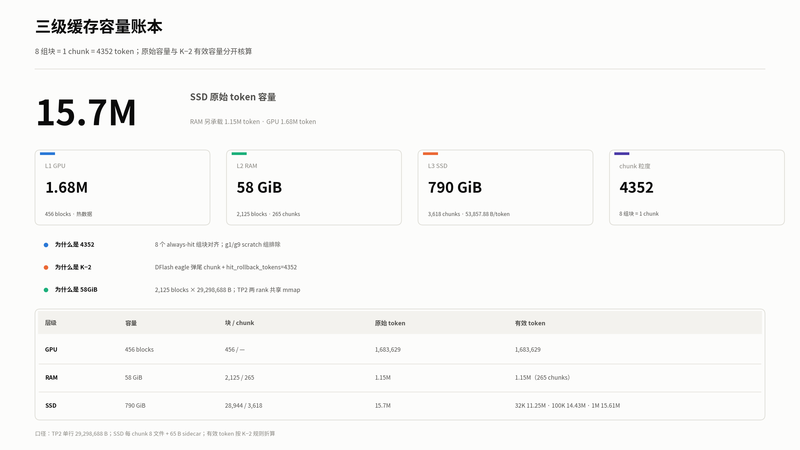
系统在 vLLM 原生 OffloadingConnector 上实现三级 KV 缓存:GPU 层保留热块,RAM 层以 58GiB 共享 mmap 承载温块,SSD 层以 790GiB 文件缓存承载冷块;按 4352 token 的 chunk 粒度存取,支持 LRU 淘汰、95%/90% 高低水位准入、活动块保护、SHA-256 逐块校验、正常重启与 SIGKILL 后恢复、OOM 自动回滚;同时处理 TP2 双 rank 异质 cell 协商、Mamba 尾 chunk 恢复、DFlash draft 组排除和 SSD O_DIRECT 对齐。
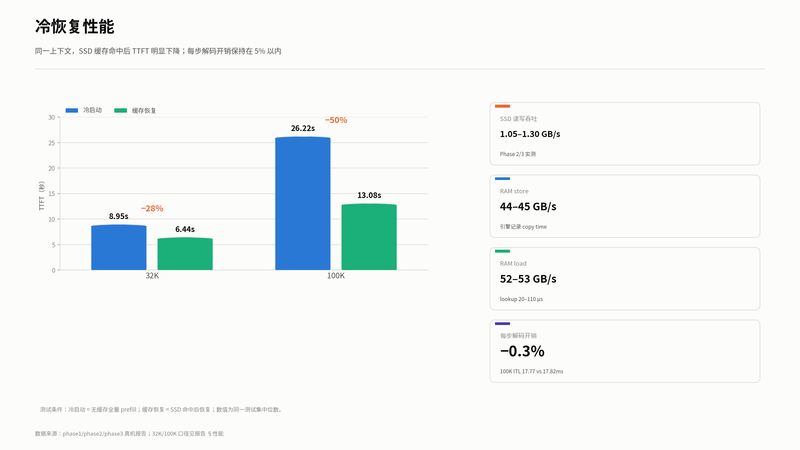
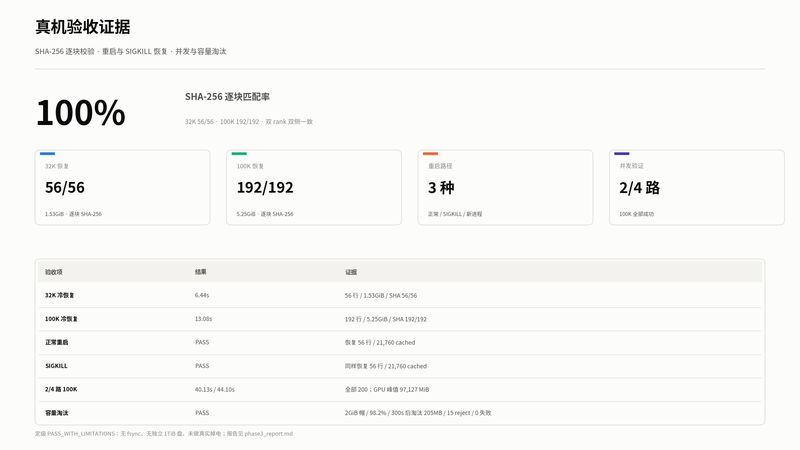
我负责补丁设计、容量建模、真机验证与生产化:在 vLLM 原生 offload 源码中定位并修改 4 个核心文件;推导 8 组块=1 chunk=4352 token 的几何关系;修复 TP2 两 rank cell 尺寸不一致导致的共享内存超时;实现 K−2 恢复规则与 Mamba 尾 chunk 恢复;完成 RAM 58GiB、SSD 790GiB 扩容及 LRU/水位管理;用 SHA-256 对 56/56、192/192 块做字节级校验;完成正常重启、SIGKILL、100K 冷恢复和 2/4 路并发测试;加入启动失败自动回滚与 OOM 监控。

评论