1. 隐私合规刚需
很多企业合同、技术资料、客户数据不能直接丢给公有大模型 API;RAG 支持私有化部署、本地向量库、权限隔离、答案溯源,满足数据不出域、可审计,金融、律所、国企、政务、医疗尤其看重这点,监管越严,私有 RAG 需求越强。
2. 解决幻觉,是企业敢把 AI 用在业务里的前提**
纯大模型靠训练记忆,容易编造信息;RAG 让 AI 回答必须引用内部原文,自带引用来源,可核验。企业做客服知识库、制度问答、合同检索、技术手册,都要求答案可信,这是业务底线。
3. 成本优势明显
相比给垂直行业做模型微调(数据集难、成本高、迭代慢),RAG 上手更快、改知识库就能更新内容,不用重新训练模型;长上下文窗口很贵,RAG 只召回相关片段,大幅降低 token 开销。
4. 全行业通用
几乎所有有文档资产的行业都能用:企业内部知识库、售后智能客服、律所合同检索、医院病历 / 文献检索、工厂设备手册、教务 / 政务资料查询等,场景非常广。
1. 基础 RAG → 进阶混合检索(BM25 + 向量 + 重排)**:现在入门款,也是你简历项目做的阶段;
2. GraphRAG(知识图谱 + RAG)**:适合复杂关联推理,比如合同关系、供应链、故障链路分析;
3. Agentic RAG(智能体 RAG)**:AI 自主判断要不要检索、多轮检索、分步查询、调用工具,不再是一问一答;
4. 多模态 RAG:同时检索文档、图片、图纸、PPT、表格,制造业、设计院需求很大;
5. 知识治理平台化:不再是单独 Demo,做成 SaaS 平台,自动文档更新、版本管理、权限、效果评测、告警,这是现在商业化主力方向。
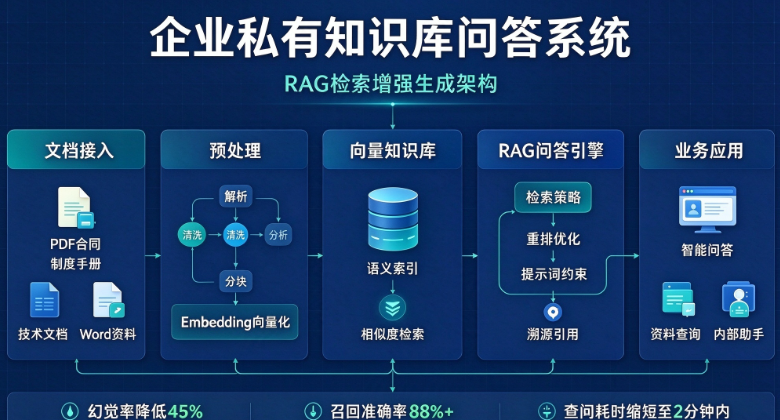
1. 完成整体方案设计:确定 RAG 整体链路,制定文档清洗、文本分块策略、Embedding 模型选型、相似度阈值调优;
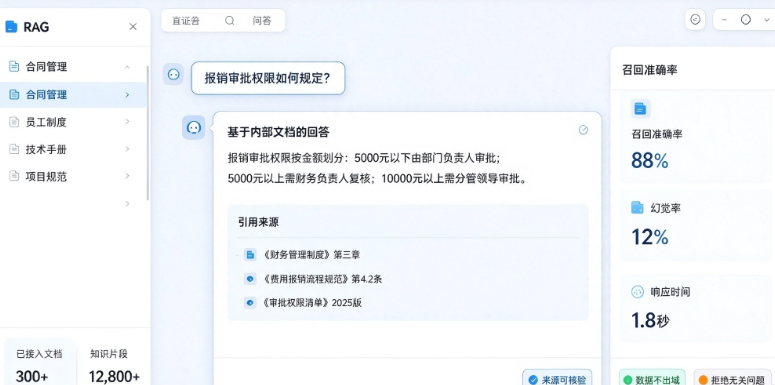
2. 设计分层提示词体系,增加引用溯源、拒绝本项目搭建了一套基于 RAG 的企业私有知识库问答系统,实现多格式内部文档上传、文本切片、向量化入库、语义检索与大模型问答能力。系统在回答时引用原文来源,有效抑制大模型幻觉;同时设计了检索策略、提示词约束与效果评估方案,解决企业内部资料分散、查阅效率低、直接使用公有大模型存在数据泄露风险的痛点,最终交付可演示的业务 Demo,支持员工基于内部制度、合同、技术手册进行智能问答无关问题的约束,抑制模型幻觉;
3. 构建评估数据集,设计问答评估指标,持续调优检索策略,解决长文档信息丢失、上下文冲突问题;
4. 制作前端简易演示页面,整理部署文档,输出整套运维和使用规范;
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论