

内部服务数量多、日志分散在各自机器上,故障往往由用户投诉才发现。运维需要一套能按规则定时巡检各服务日志、自动识别异常模式并联动告警的系统,把"被动救火"变成"主动发现",降低平均故障发现时间。


点击空白处退出提示



内部服务数量多、日志分散在各自机器上,故障往往由用户投诉才发现。运维需要一套能按规则定时巡检各服务日志、自动识别异常模式并联动告警的系统,把"被动救火"变成"主动发现",降低平均故障发现时间。
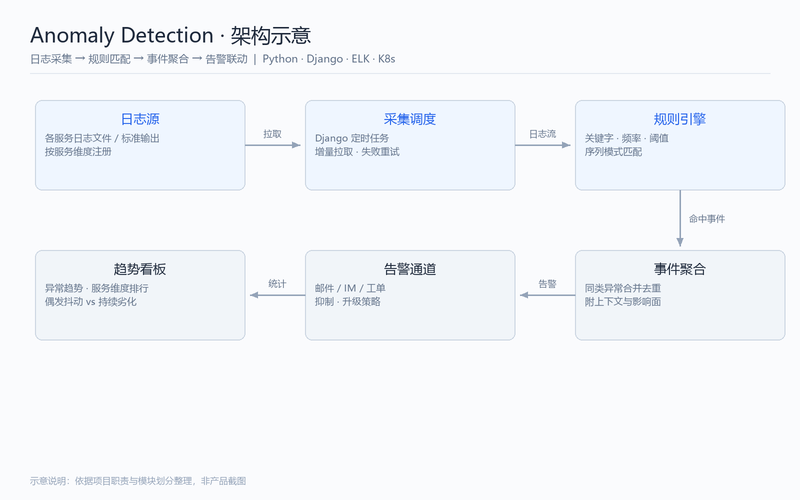
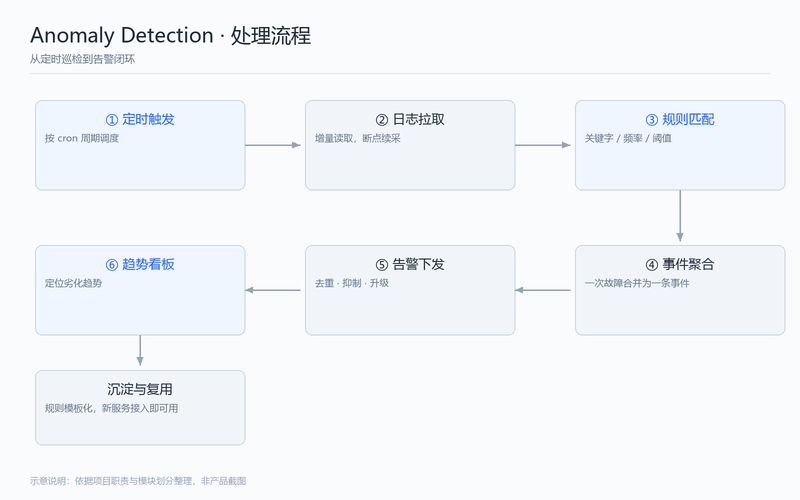
系统按可配置的时间周期拉取各服务日志,经规则引擎做关键字、频率、阈值与序列模式匹配;命中的异常聚合为事件,附带上下文日志片段与影响服务清单;支持告警去重、抑制与升级策略,可对接邮件、IM 与工单;提供异常趋势看板,便于判断是偶发抖动还是持续性劣化。
我负责该系统的开发与维护:用 Django 搭建规则配置与任务调度后台,按服务维度定时探测日志源;将采集结果写入 ELK 供检索与聚合;异常事件通过统一告警通道下发,并支持与工单联动;系统以 Docker 容器化部署在 Kubernetes 上,支持横向扩容。

评论