协作模式的隐含假设是「多模型合力把事情做完」,它提升的是产出效率,却把质量完全寄托
在产出者自身。实践暴露出三个结构性问题。其一,单模型自查存在系统性盲区,自己产出的方案
自己挑不出毛病,这是认知偏差而非能力问题。其二,同厂商的模型共享相近的训练数据与对齐策
略,盲区高度重合——多个模型都说「没问题」,并不等于真的没问题,可能只是它们一起看不见。
其三,多个模型互相客气地补充完善时,产出的一致性会被误当成正确性,共识的假象比分歧更危
险。
严苛审查模式把多模型的正确用法从「互相帮忙」改为「互相挑刺」:一个产出、多方独立审
查、争议公开仲裁。这样一改,多模型的价值从劳动力叠加变成视角叠加——审查结论不再依赖任
何单一模型的判断力,而依赖多个异构视角的交叉验证。这正是本方案要落地的目标。
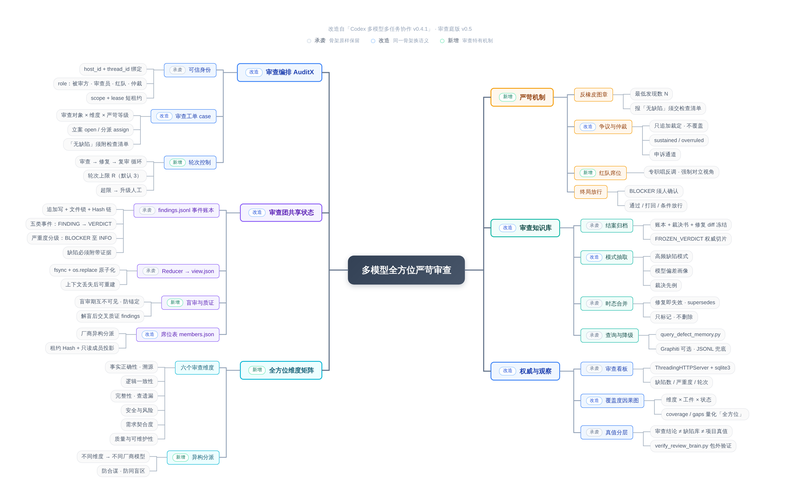
编排层从「任务管理」改为「案件管理」。工单模型升级为 case = 被审工件 × 审查维度集合
× 严苛等级:工件在立案时做只读快照,防止审查期间被偷改;严苛等级分快扫、标准、深审三
档,决定启用的维度数量与每维度的最低发现数 N。角色从单一的「成员」拆成四种
——producer(被审方,拥有申诉权)、reviewer(审查员)、red-team(专职唱反调的席位)、
arbiter(仲裁,即原总控),四者的写入权限在席位表中严格分离。
轮次控制是这一层新增的关键约束:审查、修复、复审构成一个循环,最多 R 轮(默认 3);
到上限仍有 BLOCKER 级缺陷未清零时,不再继续机器博弈,直接升级人工裁决。可信身份机制
原样保留:host_id + thread_id 绑定 role / scope / lease,任何写入先验身份。
假阳性是最大的运行风险,误伤会打击 producer 的信任,导致审查被抵触——申诉通道与三
态裁定状态是兜底,被推翻的 finding 留痕不删除,误伤本身也会沉淀为模型偏差画像,反过来校
准分派。深审拖延是第二大风险,轮次上限与人工升级是硬刹车。异构的局限要诚实面对:市面上
可选的厂商模型终究有限,阵容需要定期轮换,并用偏差画像持续跟踪「谁和谁总是看不见同一类
问题」
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论