

随着大语言模型逐渐应用于自动化编程和软件维护,AI Agent 已经能够自主生成、修改和执行代码,但生成结果可能存在隐藏逻辑错误,单纯依赖模型判断或公开测试难以保证可靠性。
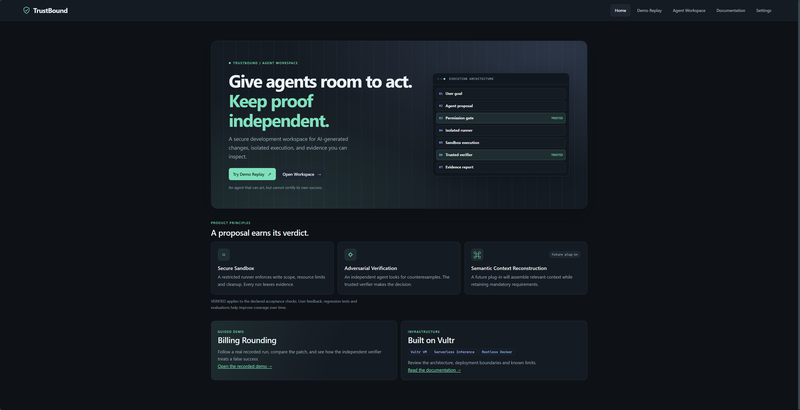
TrustBound 面向 AI 自动代码修复与软件质量验证场景,探索如何通过隔离执行、独立测试、对抗验证和失败恢复机制,提高自动化代码修改过程的可验证性与安全性,为 AI 辅助开发、自动化测试和软件维护提供工程实践方案。


点击空白处退出提示



随着大语言模型逐渐应用于自动化编程和软件维护,AI Agent 已经能够自主生成、修改和执行代码,但生成结果可能存在隐藏逻辑错误,单纯依赖模型判断或公开测试难以保证可靠性。
TrustBound 面向 AI 自动代码修复与软件质量验证场景,探索如何通过隔离执行、独立测试、对抗验证和失败恢复机制,提高自动化代码修改过程的可验证性与安全性,为 AI 辅助开发、自动化测试和软件维护提供工程实践方案。
1. **AI 自动代码修复**:接入大语言模型,根据任务描述及测试反馈生成候选修复代码,并交由执行模块验证。
2. **Docker 沙箱执行**:利用容器隔离代码执行环境,限制运行权限与执行时间,降低不可信代码的运行风险。
3. **独立自动验证**:通过独立验收流程执行测试,生成结构化验证报告,判断候选修复是否满足预期要求。
4. **对抗测试机制**:利用独立的对抗模块寻找能够暴露隐藏错误的反例,检测公开测试未发现的问题。
5. **失败恢复机制**:支持对失败候选进行修复调整与反例回放,验证已发现的问题是否得到解决。
6. **Web 操作界面**:基于 FastAPI 提供本地操作入口,展示任务执行、测试结果和验证状态。
7. **自动化回归测试**:使用 pytest 构建测试体系,验证关键功能和系统行为的一致性。
本人负责 TrustBound 的系统方案设计、核心流程实现、模块集成、实验验证与工程测试,并使用 AI 编程工具辅助开发。
项目基于 Python、FastAPI、Pydantic 和 Docker 构建,采用模块化架构组织任务执行、候选修复、独立验证、对抗测试与恢复流程。
**主要实现工作:**
1. **任务与数据契约**:设计 TaskSpec、ExecutionResult、VerificationReport 等结构化数据模型,规范任务输入、执行输出与验证结果,提升模块间的数据一致性。
2. **容器化隔离执行**:基于 Docker 构建非 Root 权限的代码执行环境,配置运行超时、工作区路径检查及容器清理机制,并分离实验执行与独立验收环境。
3. **LLM 集成**:通过模型 API 接入大语言模型,实现候选修复代码生成,并对模型响应及异常情况进行检查。
4. **对抗验证**:构建独立对抗模块,生成并校验潜在反例,通过实际执行发现候选修复中的隐藏逻辑错误。
5. **失败恢复**:对已发现的失败案例进行分析和修复调整,支持既有反例回放和回归测试,并保留验证状态以区分已通过测试与尚未完成的验证。
6. **工程质量保障**:建立自动化测试与实验记录机制,已有 75 项回归测试通过,并完成容器清理、执行权限和工作区完整性检查。
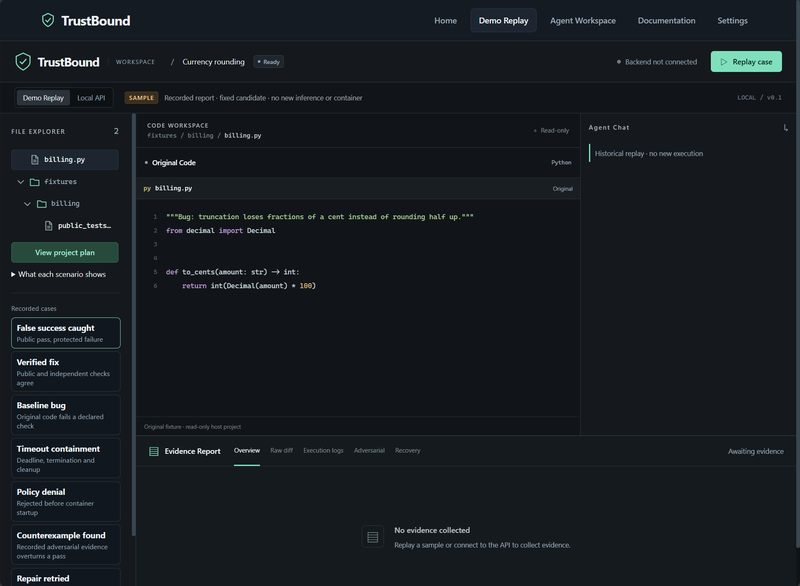
项目通过真实实验发现了初始候选修复中未被公开测试识别的数值计算问题,随后完成修复调整及反例回放。最终完整独立对抗验证仍有待进一步完成,因此未将项目声明为生产级可靠系统。

评论