

科研人员选刊投稿、图书馆做馆藏采购、编辑部做竞刊分析,都需要按学科分类汇总期刊信息:主办单位、核心收录、ISSN/CN、出版周期、作品数、被引量、H 指数和投稿联系方式。这些字段分散在维普的 16 个二级分类和每本期刊的详情页里,人工逐类翻页复制既慢又容易漏。项目要求每个分类的条数与站点显示完全一致,并且长任务中断后能接着跑,因此需要工程化的采集方案。


点击空白处退出提示



科研人员选刊投稿、图书馆做馆藏采购、编辑部做竞刊分析,都需要按学科分类汇总期刊信息:主办单位、核心收录、ISSN/CN、出版周期、作品数、被引量、H 指数和投稿联系方式。这些字段分散在维普的 16 个二级分类和每本期刊的详情页里,人工逐类翻页复制既慢又容易漏。项目要求每个分类的条数与站点显示完全一致,并且长任务中断后能接着跑,因此需要工程化的采集方案。
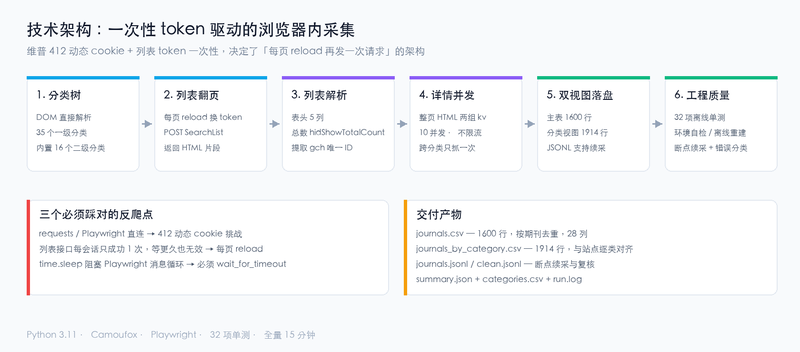
1)分类导航:解析站点分类树,自动识别 35 个一级分类,支持指定一级分类或只采某几个二级分类;
2)列表翻页:按每个二级分类逐页请求(每页 100 条),从隐藏域读取总数自动算页数,保证不漏页;
3)详情采集:按期刊唯一 ID 抓取整页详情,10 并发,跨分类重复期刊只抓一次;
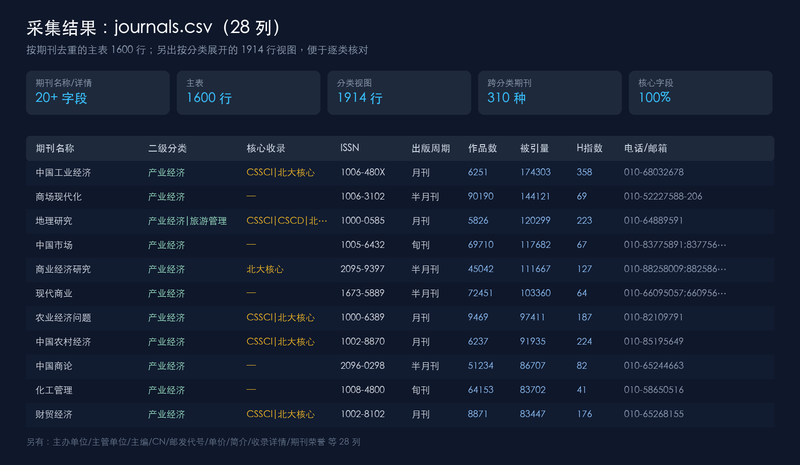
4)字段解析:输出 28 列,含主办/主管单位、主编、核心收录、ISSN、CN、出版周期、曾用名、作品数、被引量、H 指数、地址、电话、邮箱、邮发代号、单价、简介、收录详情、期刊荣誉与详情链接;
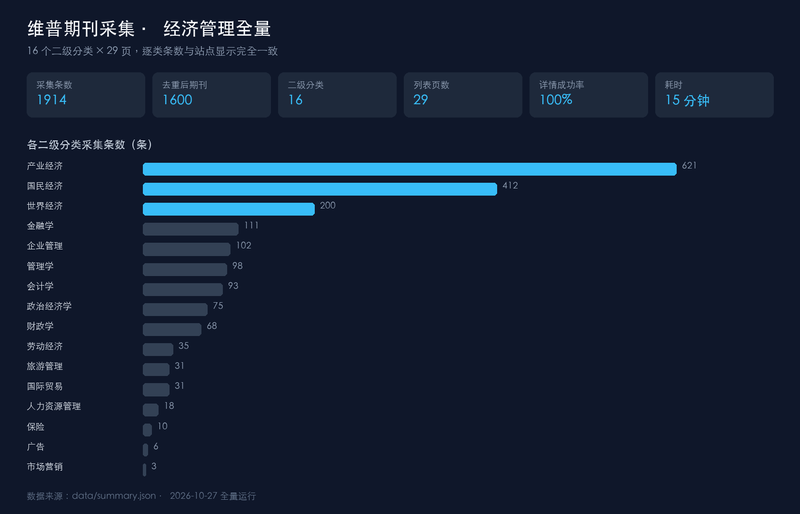
5)双视图交付:主表按期刊去重 1600 行,另出一份按分类展开的 1914 行视图,便于逐类核对;
6)稳定性:断点续采、错误分类、环境自检、离线重建脚本、32 项离线单测。
我独立完成站点分析、反爬方案选型、开发与全量验收。①站点分析:分类树直接从 DOM 解析;列表接口返回 HTML 片段而非 JSON,总条数藏在隐藏域,期刊唯一 ID 需从详情链接提取;详情页字段分布在两组不同容器里,第一版漏了其中一组,导致 ISSN/CN/出版周期全空,补齐后填充率恢复正常。②难点一:requests 与 Playwright 直连首页都返回 412,响应体是写入动态 cookie 的混淆脚本,最终选 Camoufox(Firefox 指纹伪装)过闸。③难点二:实测列表接口每个会话只能成功一次,等待 3/5/8/12 秒都无效,说明是 token 一次性而非频率限制;架构因此改为「每页重新加载列表页 → 等 1.6 秒 → 只发一次列表请求」,详情页不限流,用 10 并发补齐速度。④难点三:Playwright 同步 API 下 time.sleep 会阻塞消息循环,动态 cookie 永远生成不出来,全部改用 wait_for_timeout。⑤去重设计:简单按期刊去重会让「企业管理」这类高度重叠的分类整类消失,所以主表保留合并分类,另出分类视图。⑥验收:16 个分类全部对齐,1914 条与站点逐类一致,1600 种期刊详情 100% 成功、0 失败,15 分钟跑完,32 项单测通过。

评论