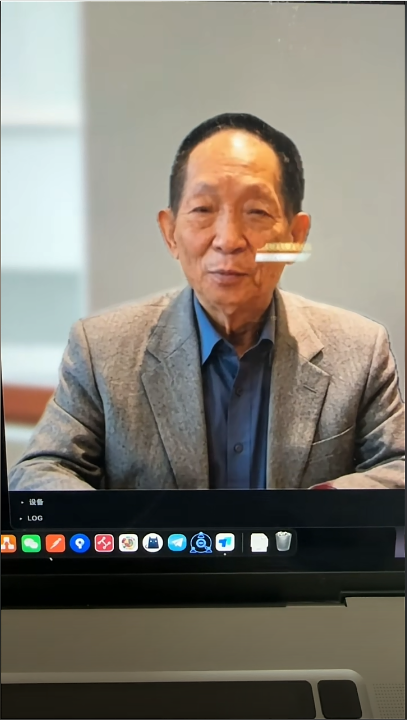
本项目面向展馆、纪念馆、博物馆、红色教育基地等文化展陈场景,构建“可与已故伟人/历史人物进行第一人称对话”的沉浸式数字人叙事系统。系统以权威史料和历史研究成果为基础,通过 AI 数字人、知识库、剧本化叙事和多模态交互,让观众在展馆现场与“伟人数字形象”对话,听其介绍历史背景、讲述亲身经历中的故事、回答观众问题,从而把传统“看展板、听讲解”的参观方式升级为“可提问、可对话、可沉浸”的历史教育体验。
当前展馆行业正在从静态陈列向数字化、沉浸式、互动化升级。传统展陈以图文展板、实物展品、人工讲解和音视频为主,观众被动接收信息,停留时间短、参与感弱、个性化不足。与此同时,AI 数字人、大模型问答、语音合成、知识库检索、虚拟现实和空间互动等技术逐步成熟,为展馆提供了新的叙事入口。
“与已故伟人对话”具有天然吸引力:它能将宏大的历史叙事转化为有温度、有情境、有细节的个人讲述,增强观众对历史人物、历史事件和精神内涵的理解。但这类业务同时具有强内容属性、强教育属性和强合规属性,不能简单套用娱乐型聊天机器人,需要以“史料权威、表达审慎、体验沉浸、运营可控”为核心原则。
定位:面向展馆的 B/S 架构 Web 应用,支持多用户登录、多人并发、实时语音对话和口型同步数字人,核心对话链路采用 Realtime 大模型。
核心功能
多用户登录与权限
观众、讲解员、内容编辑、审核员、管理员等角色;
支持账号登录、扫码/SSO、展馆终端自动登录、游客轻登录;
会话隔离、并发限流、断线重连、团体对话房间。
数字人呈现与口型同步
Web 端 3D/2D 数字人渲染,适配大屏、一体机、平板、PC;
音频流实时驱动口型,音画同步;
支持表情、动作、倾听/待机状态;
用户打断时立即停止发声并收口型;
低性能终端自动降级为轻量口型。
实时对话(Realtime 大模型)
端到端流式语音对话,低延迟首响应;
支持语音打断、多轮上下文、语音+文字混合提问;
实时字幕、音色与人物风格配置;
知识库 RAG 增强,回答附史料出处;
敏感/超范围问题拒答或转人工讲解员。
内容与知识库
人物生平、历史事件、展品档案、FAQ 知识库;
剧本化讲述与自由问答两种模式;
内容审校、发布、版本回滚;
史实/演绎/评价分级标注。
展项联动
对话中触发展品点亮、视频播放、时间线展示、展区切换;
支持引导式提问和研学任务。
运营管理后台
终端管理、实时监控、对话质检、数据看板;
模型/音色/口型/并发/降级配置;
登录与操作日志审计。
1. 实时对话链路
浏览器麦克风 → VAD 检测 → WebRTC 音频上行(或 WebSocket)→ Realtime 大模型 → 音频流下行 → 数字人口型驱动 + 播放,同时输出文本字幕和结构化事件(动作、展项指令)。
传输选择:优先 WebRTC,UDP 优先保低延迟,内置抖动缓冲和自适应码率;模型服务侧可用 WebSocket 作为备选。
打断机制:检测到用户插话时,立即清空播放缓冲、停止数字人发声并收口型,模型侧同步取消当前输出。
首响应目标:端到端 < 1s;参考 OpenAI Realtime 的 relay+transceiver 架构已做到
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论