

电商运营、外贸选品、竞品调研这类岗位,经常需要把网站上的商品列表、店铺清单或询价记录整理成 Excel 交给主管或客户。手工复制粘贴不仅慢,还容易漏行、重复、字段错位。本作品的立项原因就是把这件重复劳动标准化:给定一个列表页网址,程序自动翻页、按业务主键去重、字段对齐输出,把几百条数据搬进表格从半天压缩到几分钟。


点击空白处退出提示



电商运营、外贸选品、竞品调研这类岗位,经常需要把网站上的商品列表、店铺清单或询价记录整理成 Excel 交给主管或客户。手工复制粘贴不仅慢,还容易漏行、重复、字段错位。本作品的立项原因就是把这件重复劳动标准化:给定一个列表页网址,程序自动翻页、按业务主键去重、字段对齐输出,把几百条数据搬进表格从半天压缩到几分钟。
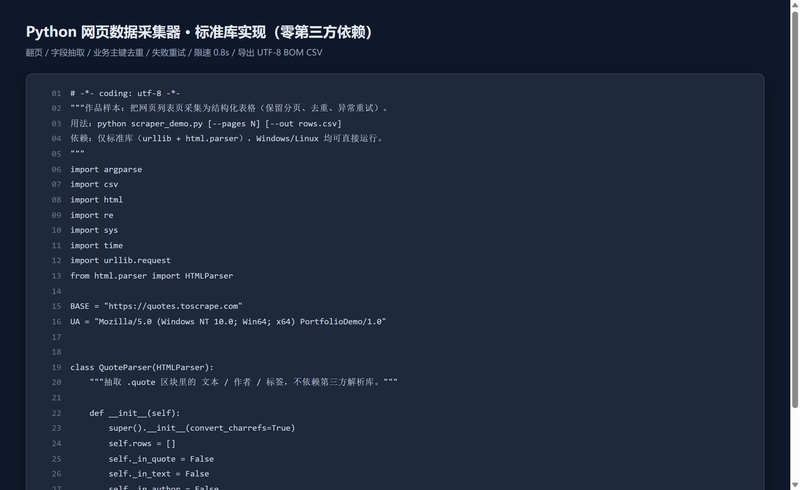
程序分四层功能模块。抓取调度层按 URL 模板自动递增翻页,遇到分页结构差异时用正则识别下一页链接,翻到底自动停止。字段抽取层用标准库 HTMLParser 按区块解析,抽出标题、价格、标签、页码等字段,不依赖第三方解析库。数据治理层以业务主键去重,重复行静默丢弃并计数,空值与缺字段单独统计。输出层导出 UTF-8 BOM 的 CSV,Excel 双击即开不乱码。全过程带失败重试与 0.8 秒请求限速。
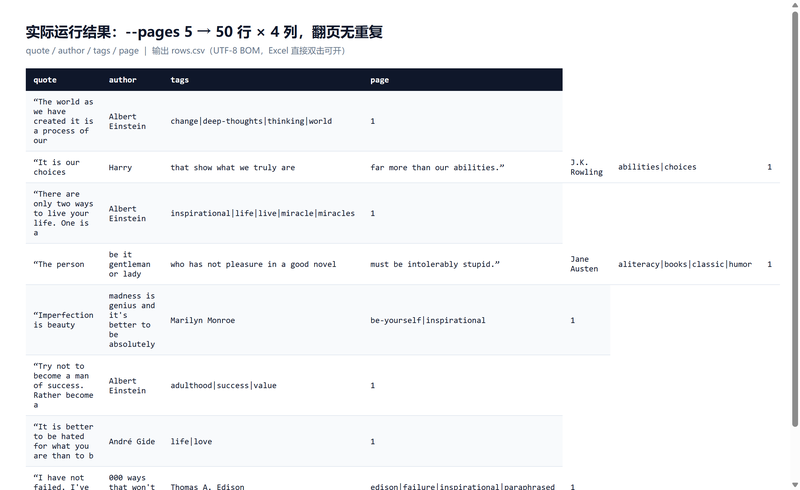
本人独立完成全部编码、测试与交付文档。技术栈为 Python 3 标准库:urllib.request、html.parser、csv、argparse、re,无第三方依赖,Windows 与 Linux 双端可运行。关键处理有三处:分页识别做成可替换的正则片段,站点改版只改一处规则;用业务主键而非行号去重,翻页重叠不产生重复数据;超时、5xx、解析异常统一走重试队列,单页失败不中断整轮任务。实测 5 页输出 50 行 × 4 列。

评论