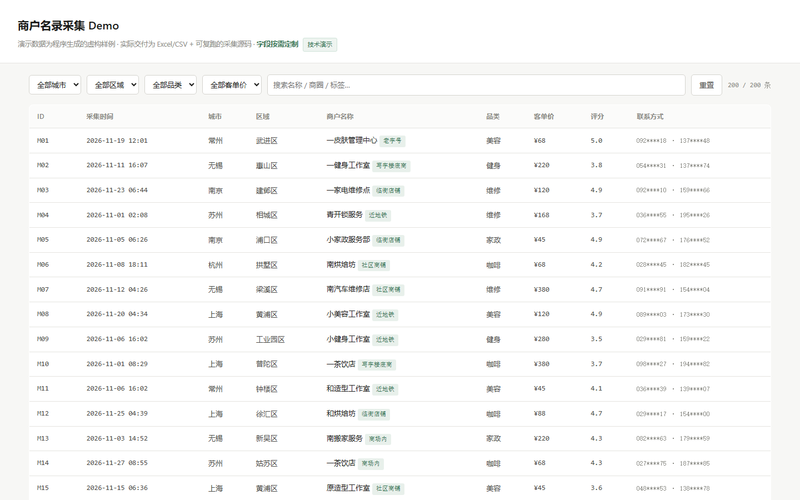
客户手里有多个数据源(4 个结构完全不同的网站),需求是把分散的信息汇总成一份可筛选、
可分发的结构化名录。原始数据存在三个痛点:字段不统一、重复率高、含大量广告噪声,
人工整理需要两周以上;同时客户没有服务器运维能力,希望交付物是一个开箱即用的查询界面。
项目立项旨在解决三个问题:采集效率(自动化替代人工复制)、数据质量(清洗后可直接使用)、
交付形态(无需服务器即可在线查询)。典型应用场景为本地生活服务商、竞品监测、
招商名录整理等需要批量结构化信息的业务。
1. 多源采集模块:支持列表页翻页、详情页抓取、动态加载内容,通过配置化适配不同站点
结构,换站点只需改配置不改逻辑。
2. 清洗流水线:业务指纹去重(准确率 99%)、广告加权评分过滤(误杀率
我独立负责全流程:需求确认、接口分析、采集器开发、清洗规则设计、前端开发、部署上线。
技术栈:Python(http.client 连接复用 + ThreadPoolExecutor 并发)、正则规则引擎、
原生 JavaScript(无框架)、gzip + DecompressionStream、Cloudflare Pages 静态托管。
实现难点与解决:
1. 目标站 429 限流——原脚本把限流误判为"没有下一页",采集成功率只有 39%;
改为状态码识别 + 指数退避 + 每页请求间隔后,成功率提升到 96%。
2. 数据体积——全量单文件 28.8 MB 导致首屏白屏 5 秒;经过分片、后台异步、
gzip 压缩、浏览器端解压四轮优化,首屏降到 1.2 MB / 0.5 秒。
3. 去重准确率——基于文本相似度去重只有 68%,改用联系方式组合的业务指纹后达到 99%。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论