

资管机构日常产生大量研报、公告、财报等文档,格式涵盖 PDF、Word、Excel 及扫描件,长期依赖人工摘录整理,效率低且易出错。为支撑投研知识库建设,需要将多格式文档批量转化为可检索的结构化数据,自动化入库。


点击空白处退出提示



资管机构日常产生大量研报、公告、财报等文档,格式涵盖 PDF、Word、Excel 及扫描件,长期依赖人工摘录整理,效率低且易出错。为支撑投研知识库建设,需要将多格式文档批量转化为可检索的结构化数据,自动化入库。
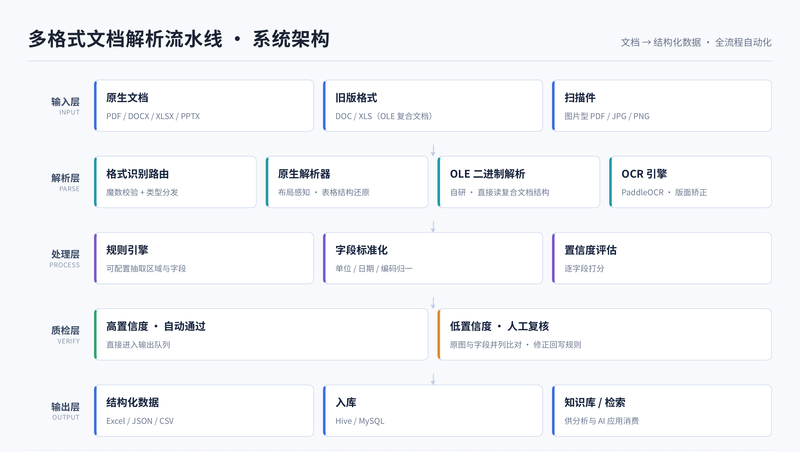
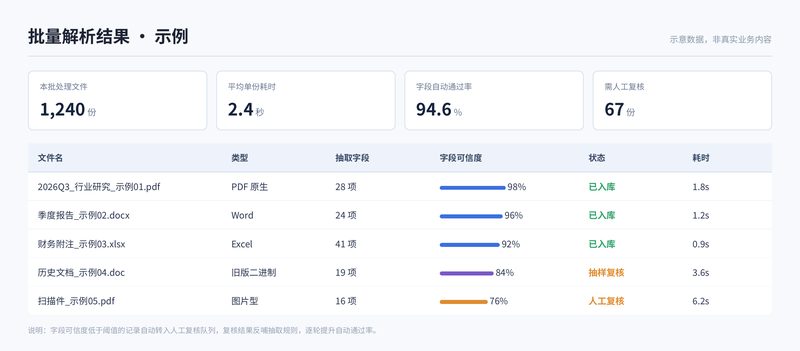
系统包含四个模块:1)格式解析,支持 PDF、DOCX、XLSX、PPTX 及旧版 DOC 二进制解析,兼容扫描件 OCR 识别;2)规则配置,通过可配置规则引擎指定抽取区域与字段,无需改代码适配新模板;3)质量校验,字段置信度分层,低置信度进入人工复核队列;4)结构化输出,结果标准化后写入数据库,供检索与分析使用。
负责整体方案选型与开发:Python 解析引擎,集成 Docling/MinerU 方案对比落地,PaddleOCR 处理扫描件;针对旧版 DOC 自研解析规则,直接解析 OLE 复合文档二进制结构,解决通用转换工具丢字段的问题。难点在于格式兼容性与解析准确率的平衡。

评论