

随着大模型和AI Agent在智能客服、金融服务及企业业务系统中的应用增加,传统测试方式难以全面覆盖多轮对话、上下文保持、工具调用、异常处理及安全风险等场景。针对Agent测试用例设计效率低、执行过程难追踪、评估标准不统一、回归测试成本高等问题,搭建通用Agent智能测试平台,实现从需求分析、测试用例生成、自动化执行到结果评估和报告输出的完整测试流程。


点击空白处退出提示



随着大模型和AI Agent在智能客服、金融服务及企业业务系统中的应用增加,传统测试方式难以全面覆盖多轮对话、上下文保持、工具调用、异常处理及安全风险等场景。针对Agent测试用例设计效率低、执行过程难追踪、评估标准不统一、回归测试成本高等问题,搭建通用Agent智能测试平台,实现从需求分析、测试用例生成、自动化执行到结果评估和报告输出的完整测试流程。
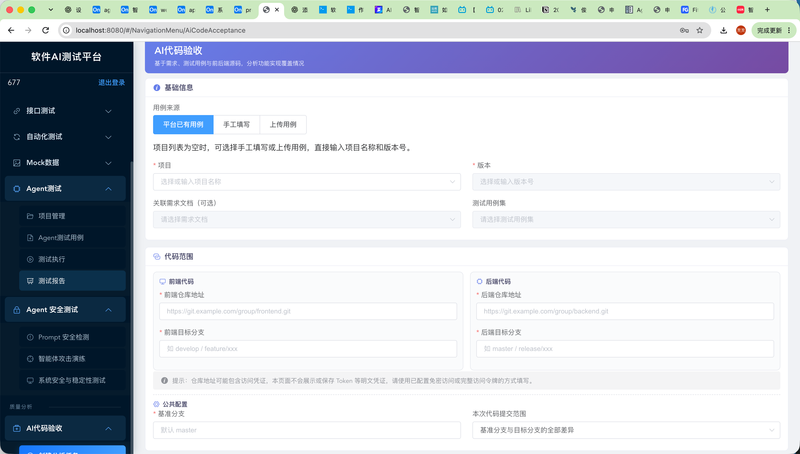
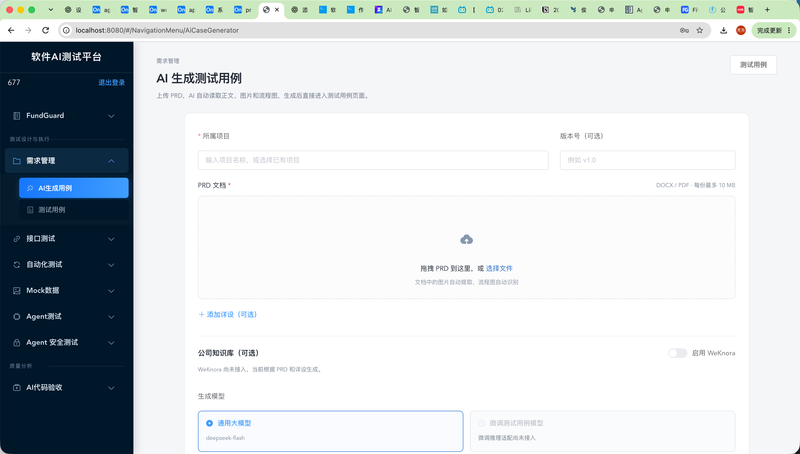
平台主要包含以下功能模块:
1. **项目与需求管理**:支持上传需求文档、源码及工具信息,关联知识库,通过大模型分析项目业务流程和测试重点,并支持人工审核。
2. **AI测试用例生成**:根据测试目标生成单轮、多轮对话测试用例,包含测试问题、前置条件、预期结果及工具调用流程。
3. **自动化执行**:支持配置执行次数、超时时间及评估方式,自动执行测试任务,记录执行状态、Trace和相关证据。
4. **Agent安全测试**:覆盖目标劫持、上下文污染、工具劫持等安全场景,验证Agent的指令遵循和工具调用边界。
5. **上下文与多会话测试**:验证多轮对话上下文保持、会话隔离、长期记忆污染及并发串扰等问题。
6. **智能评估与报告**:通过规则校验和AI Judge对执行结果进行评估,输出通过、不通过、异常及证据不足等结果,支持失败用例重测。
7. **Web智能自动化**:通过大模型将自然语言测试用例转换为JSON操作计划,由执行器调用Playwright完成浏览器操作及结果验证。
项目采用Django 4.2 + Vue 2.7 + Element UI技术栈,使用Python开发后端接口、测试任务调度及执行逻辑,前端实现项目管理、用例管理、任务执行和结果展示。
本人主要负责平台整体功能设计、核心模块开发及测试验证。
在AI测试用例生成方面,通过大模型接口完成需求分析与结构化用例生成,并将用例入库管理,支持人工审核和分页查询。
在Agent自动化测试方面,设计测试任务执行流程,支持多轮对话、工具调用记录、Trace证据采集、超时控制、任务取消和失败重测。
在Web智能自动化方面,使用DeepSeek生成结构化JSON操作计划,设计操作映射和元素定位策略,通过Playwright执行浏览器操作,并结合执行结果进行验证。
在安全评测方面,设计目标劫持、上下文污染、工具劫持及多会话隔离等测试场景,结合规则校验和AI评估分析异常行为。
在平台稳定性方面,实现并发控制、任务状态管理及异常处理,降低重复执行和任务资源冲突的风险。

评论