

项目面向企业内部文档问答场景,解决企业海量文档难以检索、信息查找低效的问题。支持 PDF/Word 文档上传、文档解析、文本切片、向量入库,基于 RAG 实现知识库问答,适配企业内部资料智能查询需求。


点击空白处退出提示



项目面向企业内部文档问答场景,解决企业海量文档难以检索、信息查找低效的问题。支持 PDF/Word 文档上传、文档解析、文本切片、向量入库,基于 RAG 实现知识库问答,适配企业内部资料智能查询需求。
多格式文档上传:支持PDF、Word、PPT、Excel,自动解析、切片、向量化建立知识库,支持扫描版PDF的OCR识别
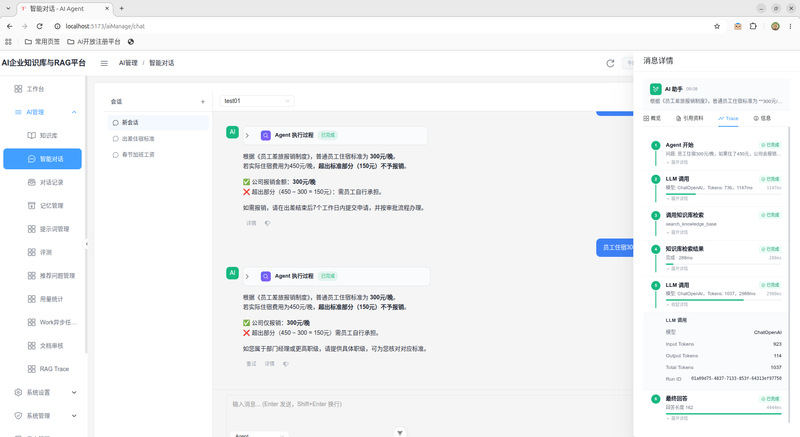
智能问答:基于检索增强生成(RAG),结合语义检索+关键词检索双路召回,回答附带引用来源,可点击溯源到具体文档
多轮对话与长期记忆:支持上下文追问,可记住用户的长期偏好和关键信息,跨会话生效
Agent智能体模式:支持大模型自主判断是否需要检索、多步调用工具完成更复杂的查询任务
防幻觉机制:知识库无相关内容时自动拒答,不编造答案
多租户与权限体系:支持多企业/多部门数据完全隔离,角色权限、菜单权限精细化管控
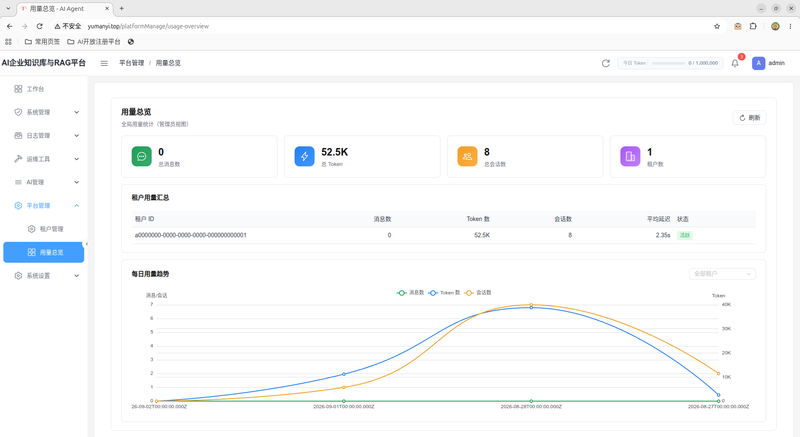
用量与成本看板:按对话、按环节统计Token消耗与费用,支持按租户/用户维度核算
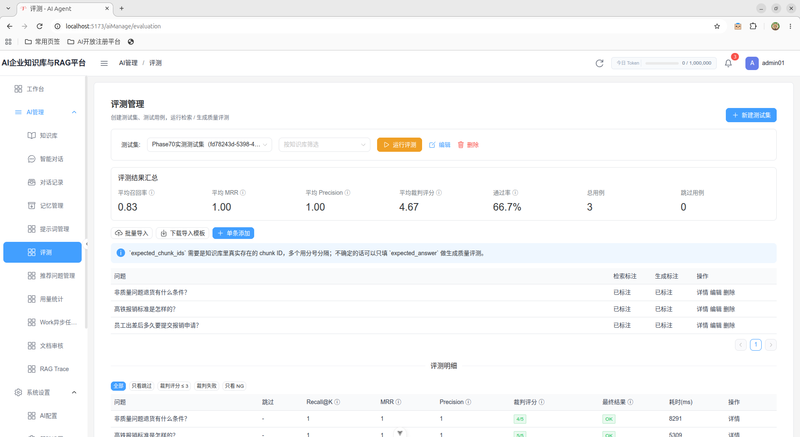
后台管理:文档管理、对话记录审计、Prompt在线配置与版本回滚、检索/生成质量评测
技术栈:前端Vue3,网关Fastify(Node.js),AI服务FastAPI(Python),数据库PostgreSQL+pgvector,缓存/队列Redis,对象存储MinIO,大模型通过OpenAI兼容协议接入(阿里云百炼)。
架构分三层:前端只负责交互,网关统一处理登录鉴权、限流、请求转发,AI服务专注RAG/Agent核心逻辑、不直接对公网暴露。网关与AI服务之间用HMAC签名+防重放机制做内部信任校验,即使AI服务端口意外暴露也无法被绕过直接调用。
核心问答链路:查询改写(多轮对话消歧)→ 向量检索+关键词检索并行召回 → RRF算法融合排序 → 置信度门控(检索质量不足直接拒答,防止大模型瞎编)→ 流式生成回答 → 引用来源校验。文档处理走异步Worker,避免大文件解析阻塞用户请求,支持失败自动重试。
工程化方面:LLM/Embedding调用均有超时、重试、熔断保护;多租户隔离采用应用层过滤+数据库行级安全(RLS)双重兜底;AI调用按环节(改写/检索/生成)分别记账,支持成本核算;内置检索召回率与生成质量的自动化评测模块。



评论