

立项原因是:联盟营销人员每周需要手动登录 Amazon Associates 后台,生成日期范围报表、下载 ZIP/Excel 文件,再逐行复制到数据库或仪表盘,过程耗时、易错、容易遗漏。业务背景是面向联盟营销和电商运营场景,需要持续追踪佣金和订单数据,但人工操作无法保证及时性和一致性。因此需要一套自动化管道,实现从登录、下载、解析到入库的全自动增量同步,让订单和收益数据始终保持最新,用于分析、结算跟踪和业务报表。


点击空白处退出提示



立项原因是:联盟营销人员每周需要手动登录 Amazon Associates 后台,生成日期范围报表、下载 ZIP/Excel 文件,再逐行复制到数据库或仪表盘,过程耗时、易错、容易遗漏。业务背景是面向联盟营销和电商运营场景,需要持续追踪佣金和订单数据,但人工操作无法保证及时性和一致性。因此需要一套自动化管道,实现从登录、下载、解析到入库的全自动增量同步,让订单和收益数据始终保持最新,用于分析、结算跟踪和业务报表。
该系统的功能模块包括:智能日期范围模块、浏览器自动化模块、Excel 解析模块、数据入库模块、幂等导入模块、日志记录模块。
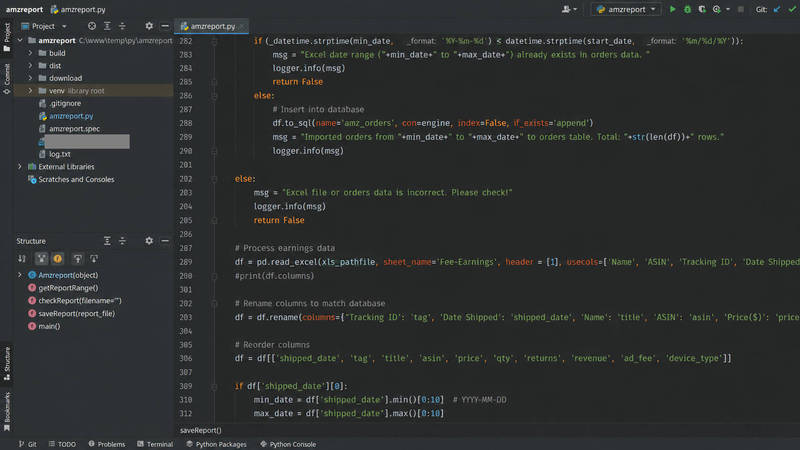
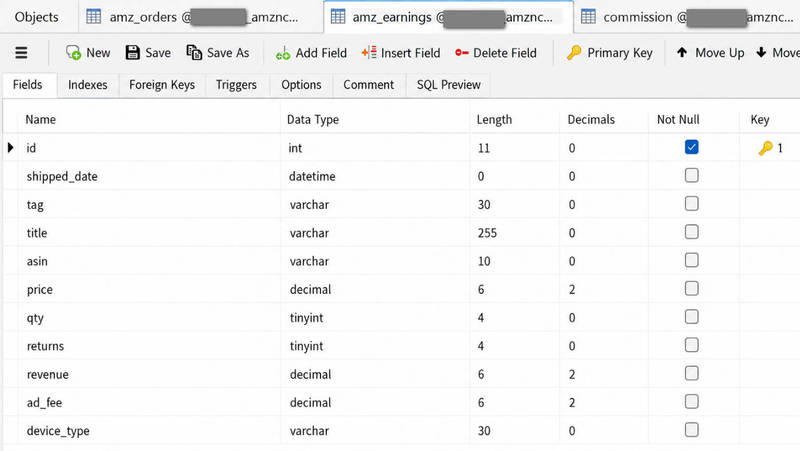
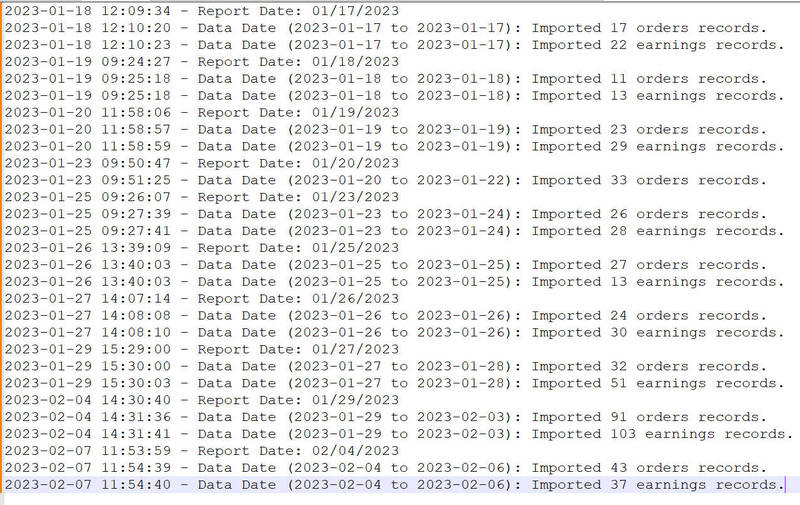
主要功能描述:智能日期范围模块查询数据库中最后一条订单日期,自动只拉取缺失时间段的数据,避免全量重复下载;浏览器自动化模块用 Selenium 和 Splinter 驱动 Chrome,配置下载偏好、禁用自动化标志,等待报表生成和文件就绪;Excel 解析模块解压报表归档,用 Pandas 读取 Fee-Orders 和 Fee-Earnings 工作表,重命名映射列;数据入库模块将清洗后的行追加到 MySQL 的 orders 和 earnings 表;幂等导入模块在文件日期范围与已加载数据重叠时跳过重复导入;日志记录模块通过 Loguru 记录每次导入的行数和异常信息。
我负责该项目的整体设计与开发。技术栈:Python 3(核心逻辑)、Selenium WebDriver + Splinter(浏览器自动化)、Pandas + openpyxl(Excel 解析)、MySQL + SQLAlchemy(数据持久化)、Loguru(日志)、PyInstaller(可选打包)。
具体工作包括:设计基于数据库最新记录日期的增量拉取逻辑;实现 Chrome 自动化登录与报表生成等待机制;编写 Excel 解压与字段映射转换流程;设计幂等导入检查,避免重复写入;配置轮转日志记录每次导入的行数和异常信息。
难点在于:Amazon Associates 后台的报表生成是异步的,需要设计可靠的等待循环判断文件是否就绪;同时要处理 Excel 多 sheet 的字段差异,设计统一的映射层。亮点是增量拉取 + 幂等导入的组合,保证数据库不会重复计数,也不会遗漏数据。

评论