

中小学教师的日常工作中,备课、批改与讲评占据大量非教学时间。以讲评一份班级错题为例,老师需要先统计错因、再逐题准备讲解、最后出补充练习,全流程手工完成通常要一两个小时。市面上面向教师的工具多集中在题库与组卷,缺少把「备课—批改—讲评—出题」串成一条流水线的产品。本项目目标是把这套重复劳动交给 AI 完成初稿,老师只做审校与决策,把时间还给教学本身。

点击空白处退出提示
中小学教师的日常工作中,备课、批改与讲评占据大量非教学时间。以讲评一份班级错题为例,老师需要先统计错因、再逐题准备讲解、最后出补充练习,全流程手工完成通常要一两个小时。市面上面向教师的工具多集中在题库与组卷,缺少把「备课—批改—讲评—出题」串成一条流水线的产品。本项目目标是把这套重复劳动交给 AI 完成初稿,老师只做审校与决策,把时间还给教学本身。
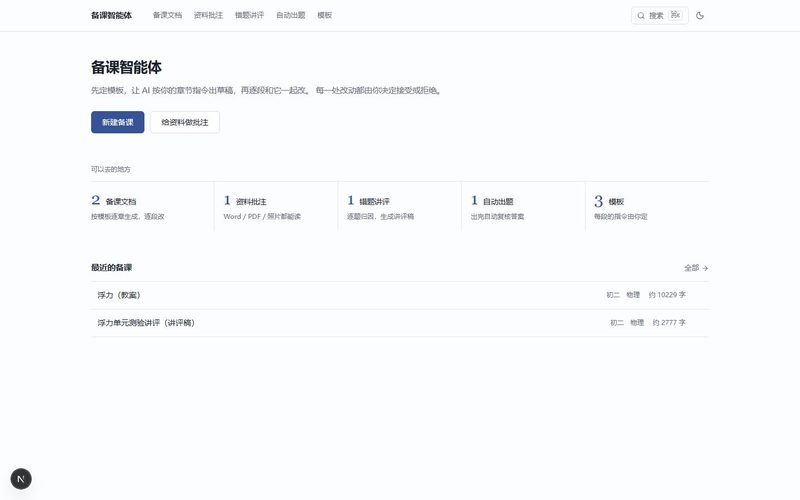
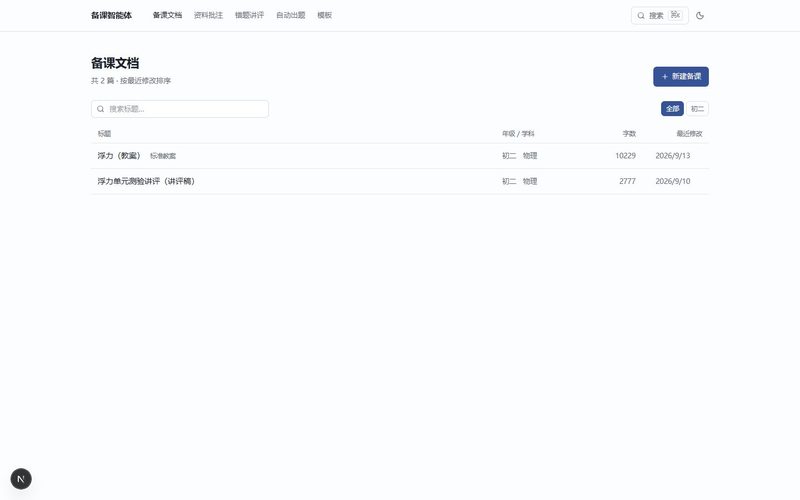
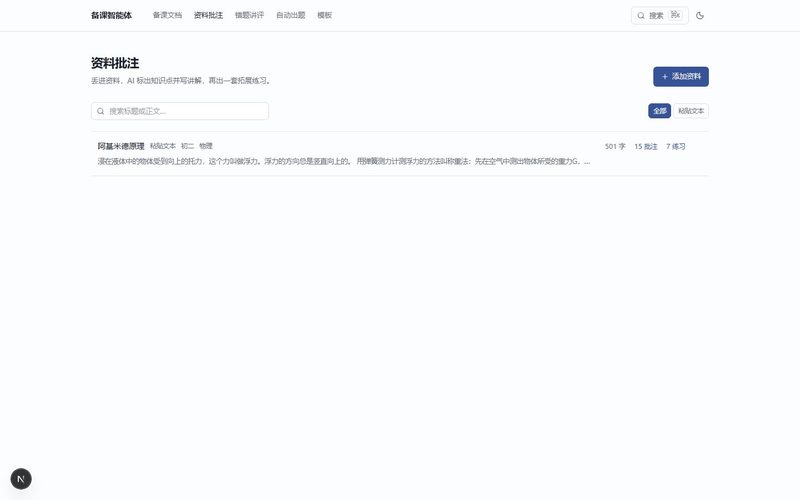
四大模块:① 备课工作台,按模板章节由 AI 出草稿,老师逐段打磨,每处改动都由使用者决定接受或拒绝,以段落级 diff 呈现改写差异;② 资料批注,粘贴文本、Word、PDF、图片、扫描件 PDF 均可投入,AI 标注知识点并撰写讲解,再生成分层拓展练习,结果可导出 Word 或导入到某份备课文档;③ 错题讲评,录入错题后 AI 逐题做错因归因,并给出学情总览、共性对策与补练题,自动拼成一份完整讲评稿,配套固定间隔复习队列(1/3/7/15/30/60 天);④ 自动出题,按学段、学科、知识点、难度、题型、题量生成整套试卷,支持逐题编辑与单题重出,导出可含或不含答案解析页。
独立完成产品设计、前后端开发与 UI 设计。技术栈 Next.js 16 + React 19 + TypeScript + Prisma/SQLite + DeepSeek API,扫描件解析使用 PyMuPDF 转图后走 DeepSeek 视觉模型 OCR。难点与亮点:① 扫描版 PDF 无文本层,通过「本地转图 + 视觉模型 OCR」实现解析,不依赖任何外部 OCR 服务,零额外成本;② 复习排期刻意不用 FSRS 算法,改用固定间隔阶梯,因为单人数据量训练不出可靠权重,属于权衡后的工程取舍;③ 文档以结构化 block 数组存储而非 markdown,编辑器用自增高 textarea 而不引入富文本框架;④ 自研自动保存(防抖 + 串行化 + pagehide/blur 补写)与快照式撤销,焦点在输入框时不劫持系统撤销快捷键。

评论