

本项目旨在解决内容平台数据分散、人工统计效率低的问题。在竞品分析、舆情监控和内容运营场景下,需要快速获取目标站点的文章、作者及互动数据。传统人工方式无法应对海量页面,因此需要一套稳定、可扩展的自动化采集系统,为业务决策提供结构化数据支撑。


点击空白处退出提示



本项目旨在解决内容平台数据分散、人工统计效率低的问题。在竞品分析、舆情监控和内容运营场景下,需要快速获取目标站点的文章、作者及互动数据。传统人工方式无法应对海量页面,因此需要一套稳定、可扩展的自动化采集系统,为业务决策提供结构化数据支撑。
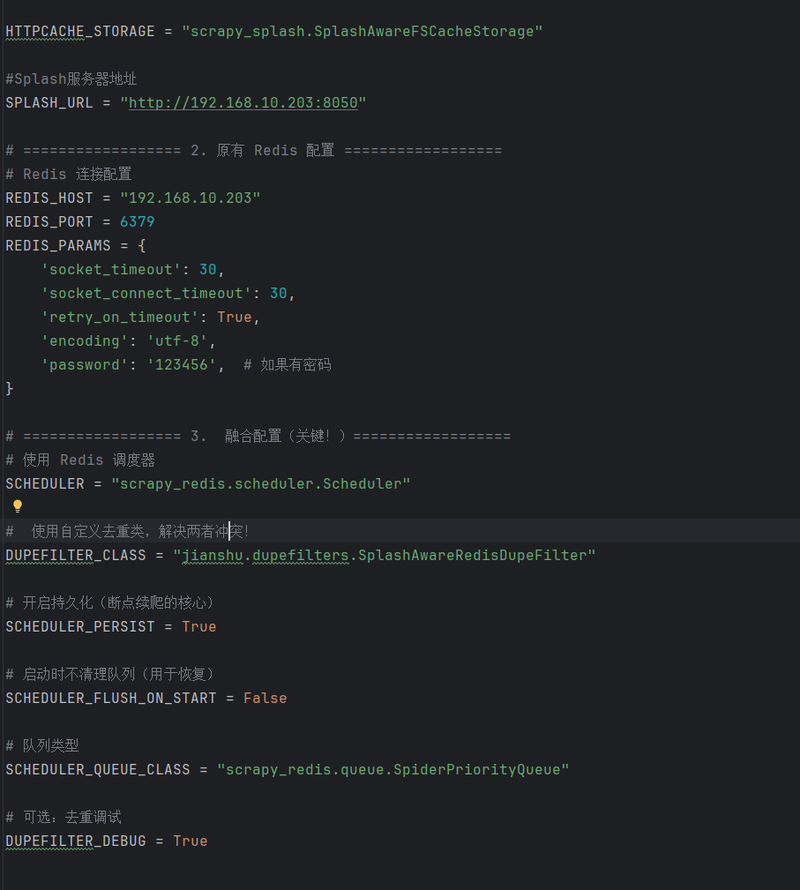
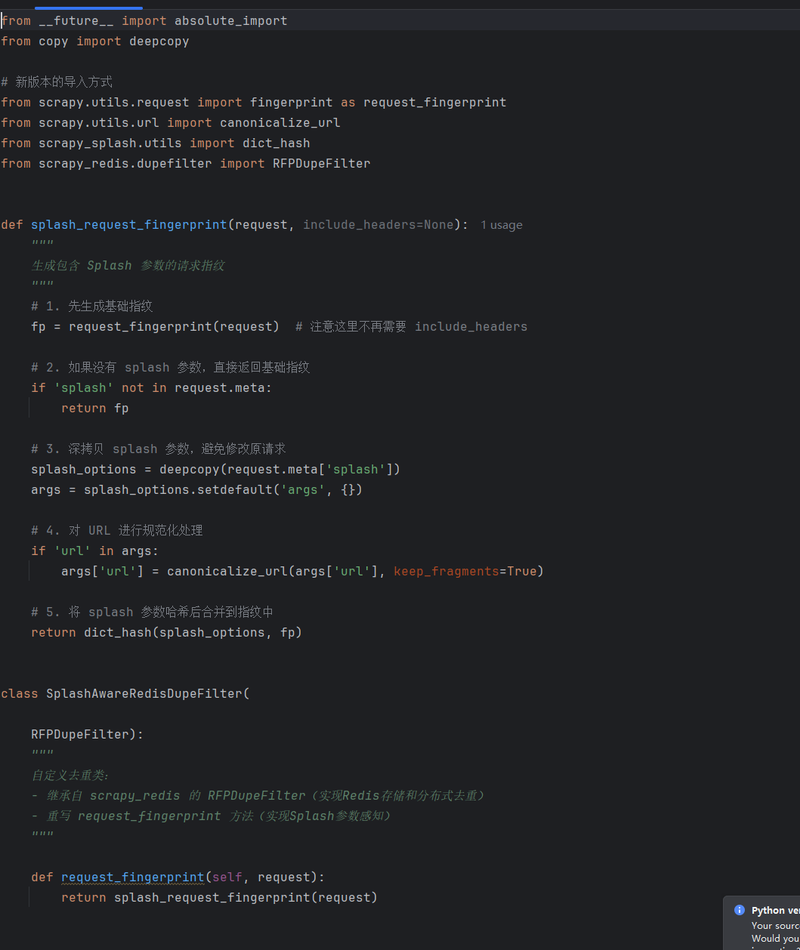
分布式采集架构:基于 Scrapy-Redis 实现多节点协同采集,利用 Redis 作为请求队列与去重指纹库,支持采集中断后从断点恢复,避免数据重复与任务丢失。
动态页面渲染:集成 Scrapy-Splash 处理 JavaScript 异步加载页面,确保获取完整的 DOM 结构,解决传统请求无法抓取动态内容的问题。
反爬对抗机制:设计代理池与随机 User-Agent 中间件,自动轮换请求身份,配合重试与超时控制,保障长时间稳定运行。
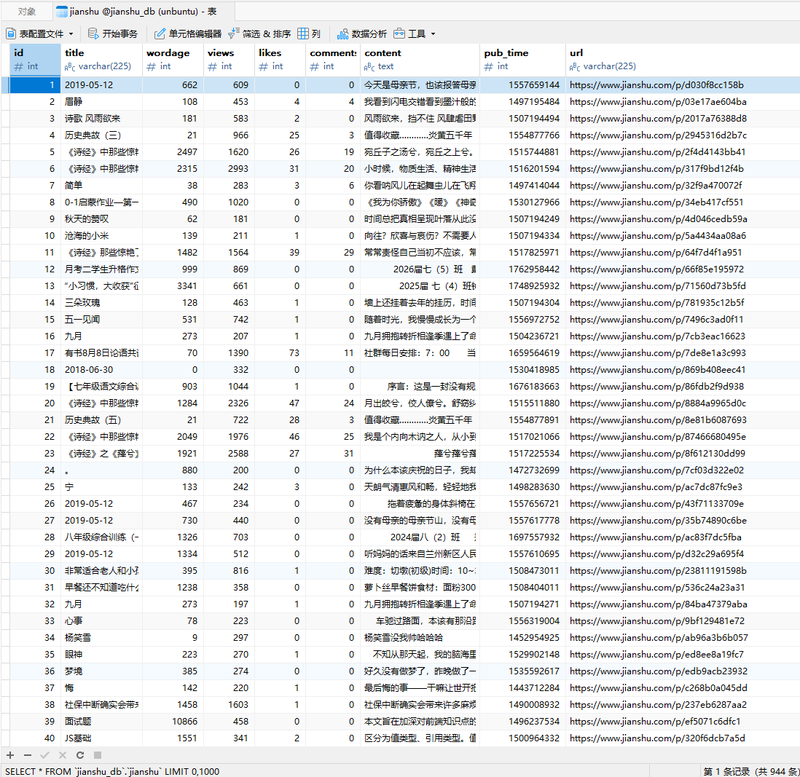
结构化数据输出:通过 Item Pipeline 对采集数据进行清洗、去重与格式标准化,最终持久化至数据库
独立完成系统架构设计与全部代码实现。核心技术难点包括:一是突破目标站点的动态渲染限制,采用 Splash 渲染服务获取异步数据;二是实现分布式任务调度,通过 Redis 共享请求队列,使多个采集节点协同工作,采集效率相比单机提升数倍;三是设计代理中间件与异常重试机制,有效应对目标站点的频率限制与反爬策略,保障采集任务长时间稳定运行。

评论