

本项目用于静态网页公开信息批量采集,解决手动复制网页数据效率低的问题。适用于公开影视信息整理场景,仅获取无需登录的公开网页内容,不抓取隐私数据。


点击空白处退出提示



本项目用于静态网页公开信息批量采集,解决手动复制网页数据效率低的问题。适用于公开影视信息整理场景,仅获取无需登录的公开网页内容,不抓取隐私数据。
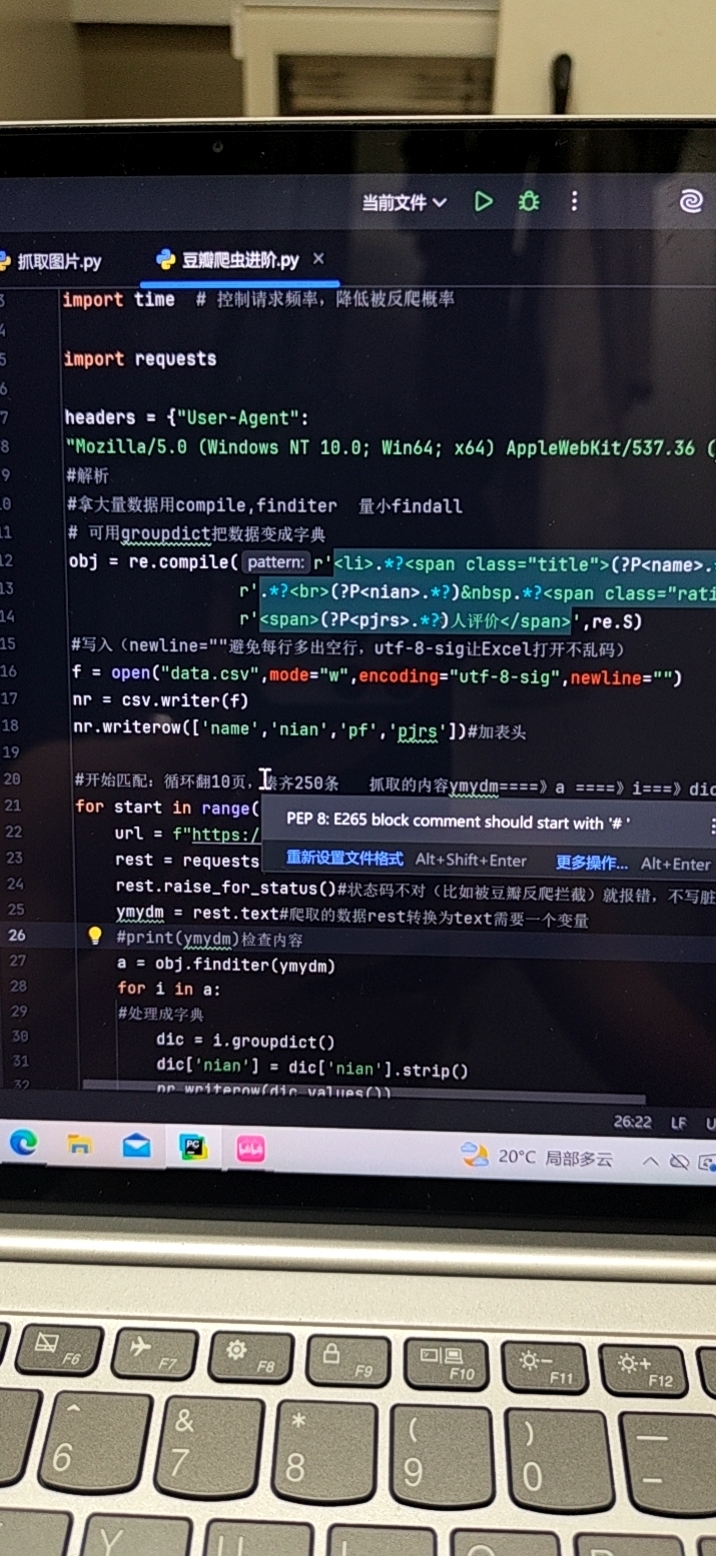
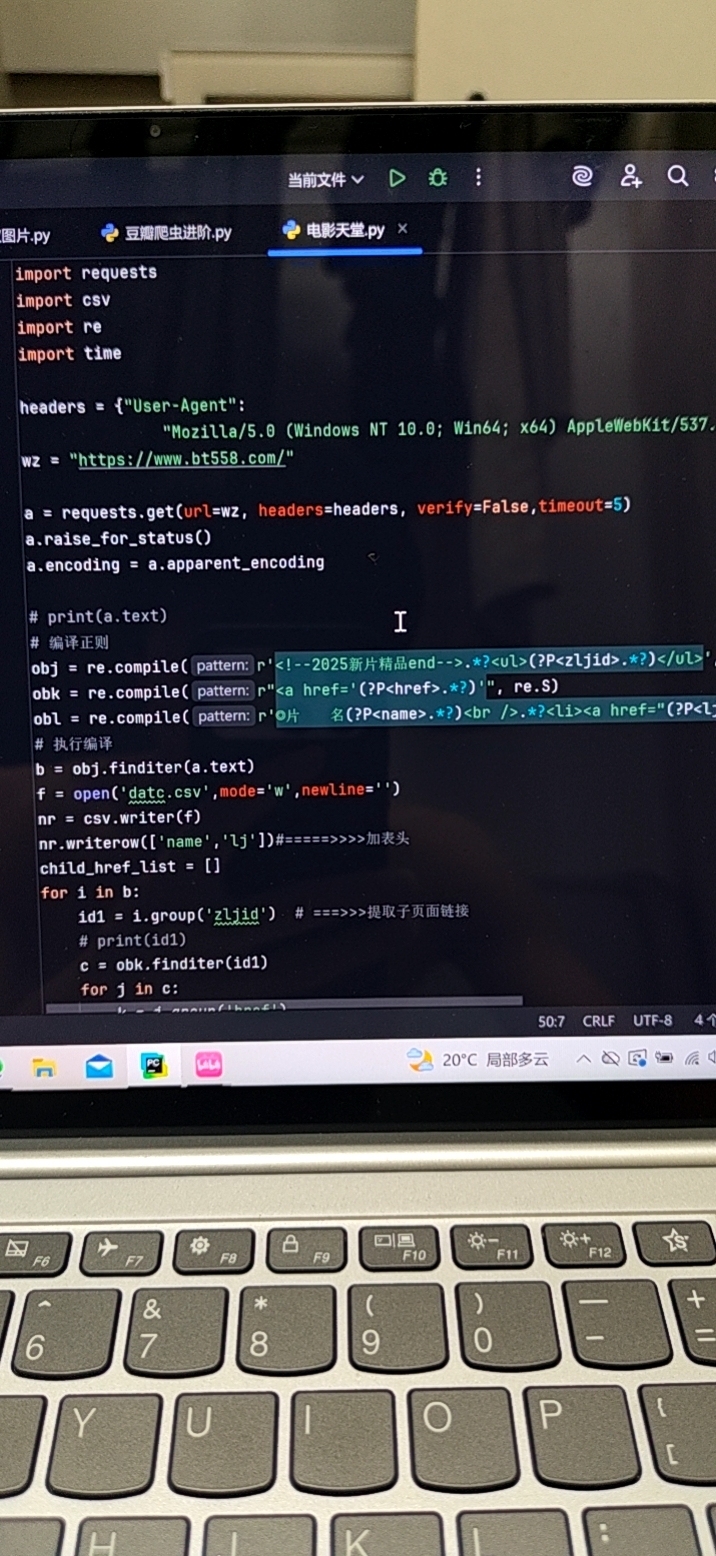
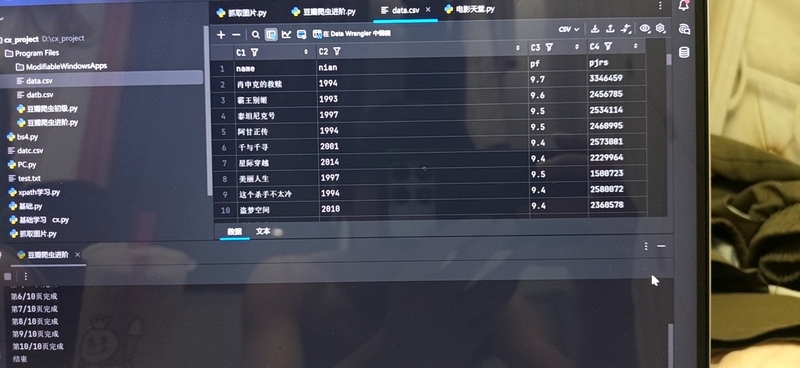
基于Python requests + 正则表达式开发爬虫脚本,支持多页循环翻页,自动提取电影名称、上映年份、评分、评价人数等公开字段。增加延时控制访问频率,将提取结果保存为CSV表格文件,代码附带注释,方便查看与修改。
独立完成全部代码编写,技术栈使用Python、requests库、正则表达式。难点在于编写正则提取网页标签内文本,增加延时避免请求过快,最终完成数据提取并保存CSV

评论