




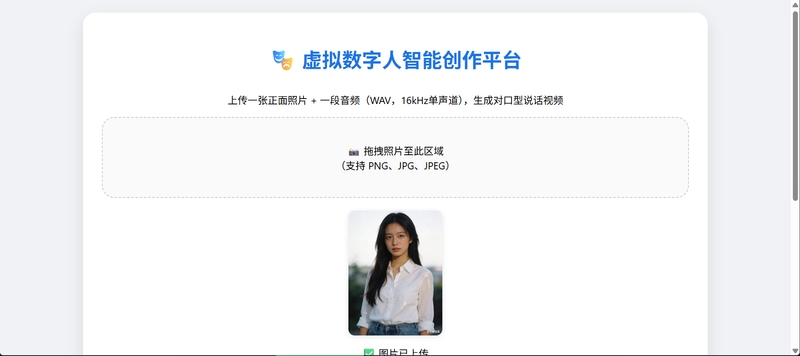
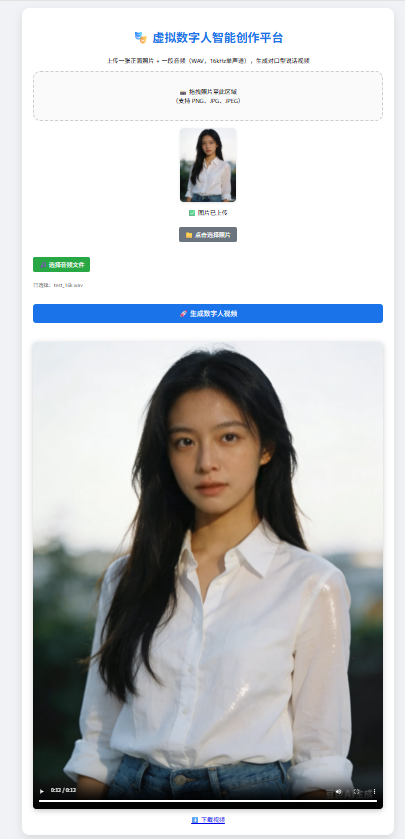
基于 Wav2Lip 模型开发的音频驱动数字人唇形同步工具,输入单张人物图片与语音音频,即可自动生成口型与音频精准匹配的数字人说话视频,人物眉眼、头部等其余面部区域保持自然静态,适用于短视频制作、数字人播报、课程配音、虚拟解说等场景。
1. 核心算法:基于 GAN 生成对抗网络架构,通过提取音频梅尔频谱特征驱动嘴部区域像素动态生成,实现音画精准同步,支持中文、英文等多语种语音适配,唇形匹配度高。
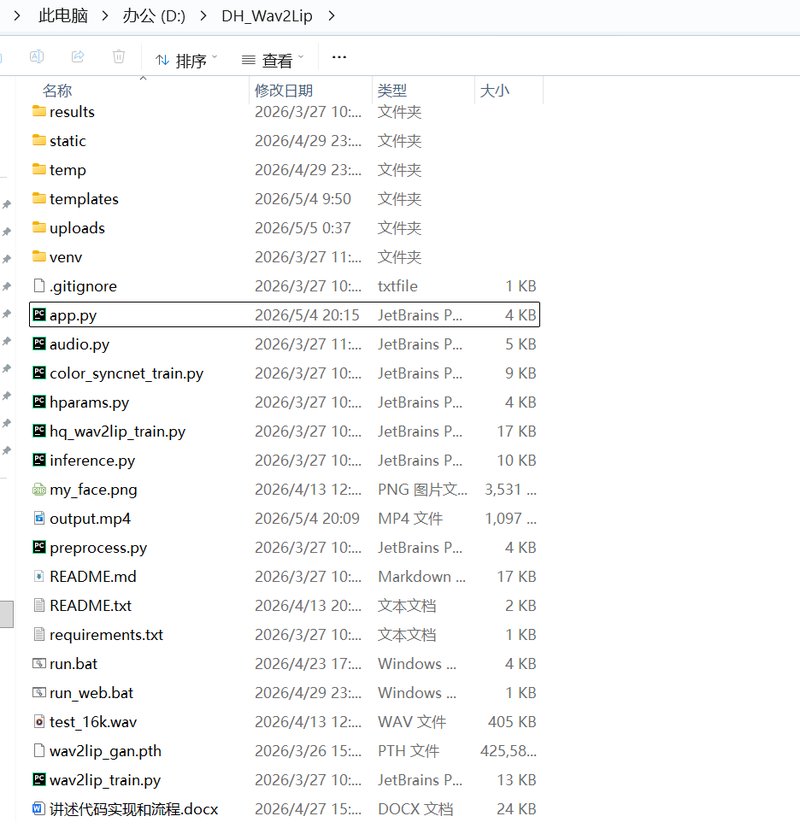
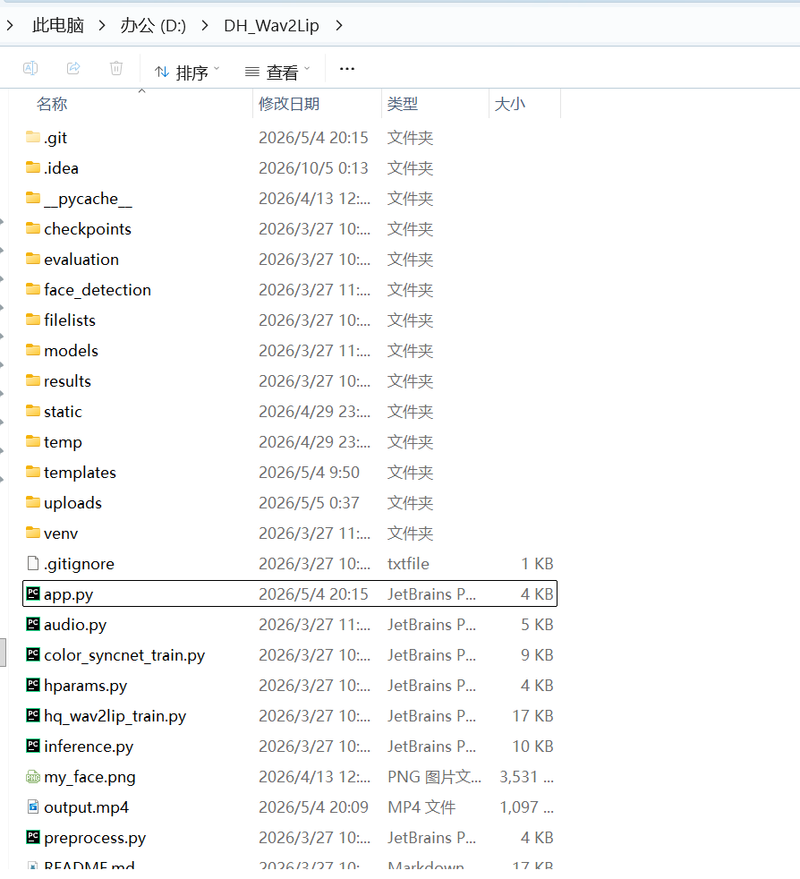
2. 全链路自动化:集成人脸检测、嘴部区域定位、音频特征提取、逐帧生成、音视频合成全流程自动处理;支持 CPU/GPU 双模式推理,可自动适配运行环境。
3. 格式与配置:输入支持 JPG/PNG 格式人物图片、WAV 格式音频(兼容 16kHz 单声道标准);输出 MP4 格式视频,可自定义帧率、输出分辨率,合成效果自然无违和感。
4. 工程优化:优化了人脸检测裁剪逻辑与音频分块策略,提升生成稳定性;封装 FFmpeg 音视频合成模块,一键输出最终成品,无需额外处理,降低使用门槛。



点击空白处退出提示
评论