

中小企业内部积累了大量制度文档——考勤假期、费用报销、信息安全、入职指南分散在网盘、群公告和共享文档里,员工遇到问题往往要翻多个文档或反复询问 HR,新员工入职适应期尤其低效;直接套用通用大模型问答又存在"不知道公司制度细节"和"答案不可溯源"两个硬伤。RAG(检索增强生成)是当前解决该问题的主流方案:先从企业自有文档中检索相关片段,再基于片段生成回答,答案有出处、可信可核查。本项目即为一个可私有化部署的轻量企业知识库问答系统。


点击空白处退出提示



中小企业内部积累了大量制度文档——考勤假期、费用报销、信息安全、入职指南分散在网盘、群公告和共享文档里,员工遇到问题往往要翻多个文档或反复询问 HR,新员工入职适应期尤其低效;直接套用通用大模型问答又存在"不知道公司制度细节"和"答案不可溯源"两个硬伤。RAG(检索增强生成)是当前解决该问题的主流方案:先从企业自有文档中检索相关片段,再基于片段生成回答,答案有出处、可信可核查。本项目即为一个可私有化部署的轻量企业知识库问答系统。
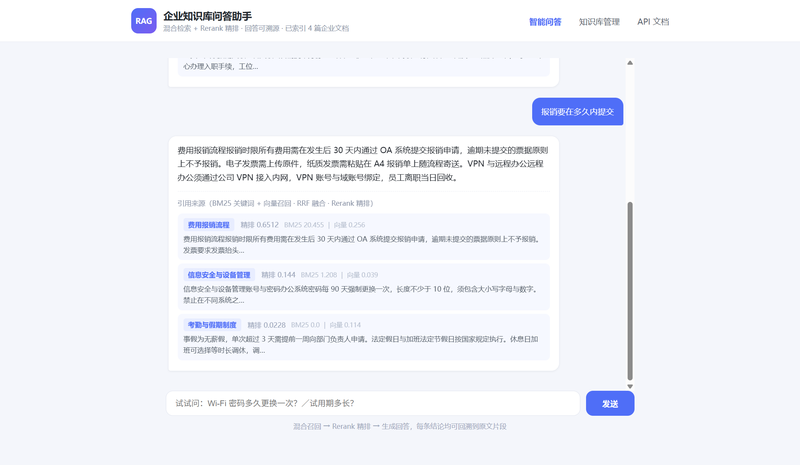
一、智能问答:员工用自然语言提问(如"年假有多少天""报销要在多久内提交"),系统返回回答并列出引用来源——包括来源文档、原文片段、关键词检索分、向量检索分与精排分,每条结论都可回溯源文。
二、混合检索:关键词与向量双路召回——BM25L 负责精确命中查询词,向量一路(哈希词袋嵌入 + 余弦相似度)补回表述有差异、部分匹配的片段;两路结果用 RRF(Reciprocal Rank Fusion)按名次融合成候选池,只依赖排名而不依赖分数量纲,天然适合异构分数融合。
三、Rerank 精排:对融合候选池做多特征重排——查询词覆盖率为主,两路检索归一分为辅,输出统一精排分后截断返回 top-3;精排器接口对齐 Cross-Encoder 重排模型,可直接替换为 bge-reranker 或线上 Rerank API。
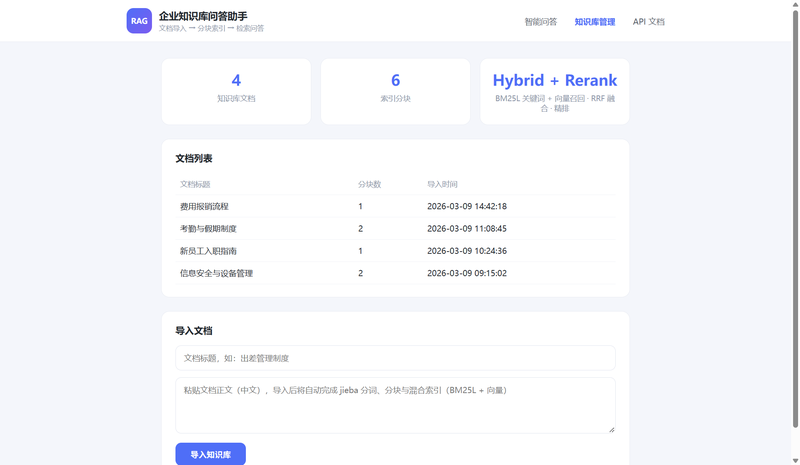
四、知识库管理:文档列表、纯文本导入与 txt/md 文件上传,标题幂等去重;文档进入后自动完成 Markdown 标记清洗、句子粒度分块(相邻块保留重叠上下文)与双路索引构建。
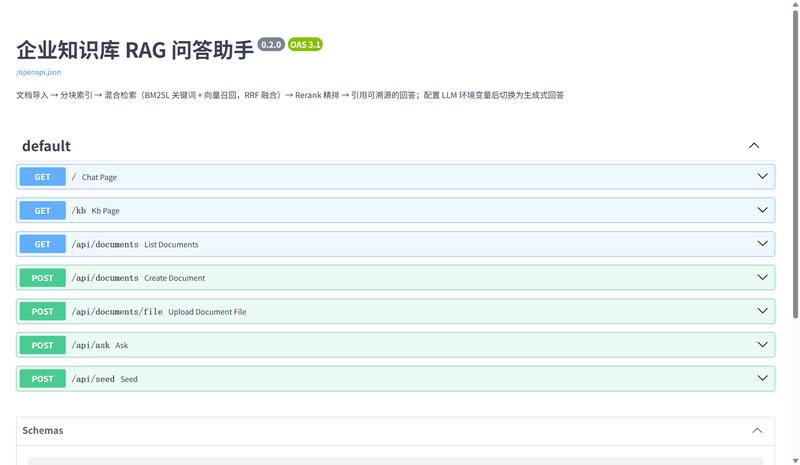
五、回答生成与 API:默认抽取式回答(纯本地零依赖);配置 OpenAI 兼容 API 环境变量后自动切换 LLM 生成式回答;FastAPI 自动生成交互式 API 文档,问答与导入接口可供第三方系统集成。
本人独立完成架构设计、全部后端开发与前端页面。后端采用 Python + FastAPI,检索链路分层组织:chunker(分块)→ store(SQLite 持久化)→ retriever(BM25L + 向量双路,RRF 融合)→ reranker(精排)→ llm(回答生成)→ service(编排),召回、精排、生成三层解耦,可分别替换为向量数据库、Cross-Encoder 与不同大模型。亮点:一是完整的"混合召回 + 精排"两段式检索,引用同时携带两路分数与精排分,检索过程透明可解释;二是 BM25L 替代经典 BM25Okapi,规避小语料下 IDF 为负导致检索失效的缺陷;三是嵌入器与精排器均为接口化设计,哈希词袋嵌入本地即可跑通全链路,换真实语义嵌入或重排模型零改动;四是配套 14 个 pytest 用例覆盖分块、双路检索、融合、精排与服务端到端。

评论