

立项原因:实验室和检测机构每天要从仪器和系统导出大量 Excel,再靠人工筛选、
拆分、比对、统计,一份日报往往要搬半天,还容易抄错、漏行。商业插件要么太重、
要么要联网授权,中小实验室用不起也用不上。业务背景:我在实验室 IT 岗位做了
13 年(4 年国际第三方检测 + 9 年制药),这类重复搬运是最常见、也最耗人的环节,
所以自己写了一个轻量、双击即用、不需要管理员权限的 Excel 插件。


点击空白处退出提示



立项原因:实验室和检测机构每天要从仪器和系统导出大量 Excel,再靠人工筛选、
拆分、比对、统计,一份日报往往要搬半天,还容易抄错、漏行。商业插件要么太重、
要么要联网授权,中小实验室用不起也用不上。业务背景:我在实验室 IT 岗位做了
13 年(4 年国际第三方检测 + 9 年制药),这类重复搬运是最常见、也最耗人的环节,
所以自己写了一个轻量、双击即用、不需要管理员权限的 Excel 插件。
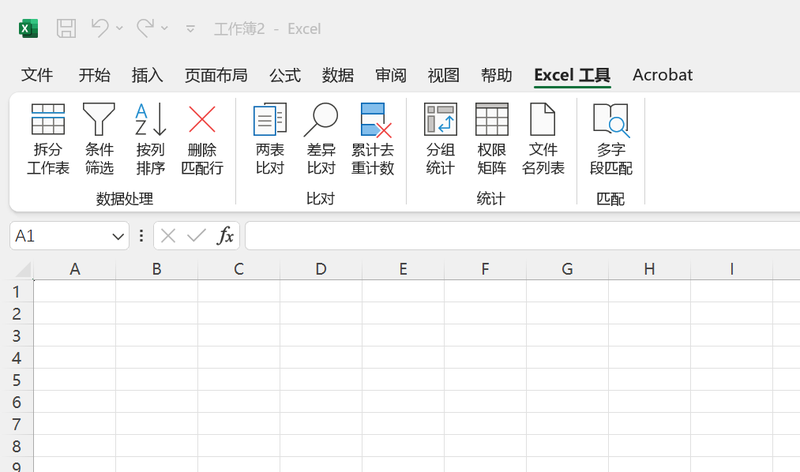
共 11 个工具,分四组。
一、数据处理:按某列值把总表拆成多个工作表;多条件筛选到新表(逐行匹配与
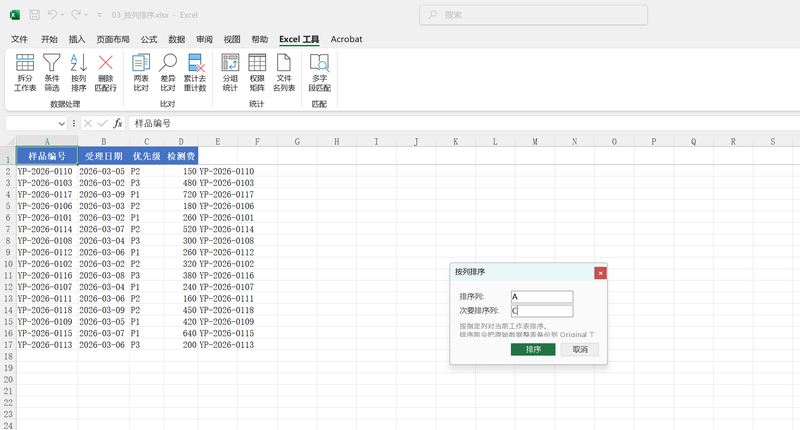
SQL 两种模式);按指定列排序并自动备份原始数据;删除与另一表匹配的行。
二、比对:两表数据差异比较;按匹配列联两表、找出比对列不一致的行;
截至每行统计某列累计不重复值数。
三、统计:按分类字段生成交叉汇总表(分类×月份+合计);从数据生成角色×功能
权限矩阵;递归提取目录下所有文件名。
四、匹配:按多字段联合匹配两表并回填 Key 值。
所有列名、表名均由用户输入,不硬编码。
独立承担需求梳理、架构设计、全部编码与交付文档。技术栈:C#/.NET 6.0 +
Excel-DNA 1.9.0,用 dynamic COM 与 Excel 交互,大数据量走 OleDb/SQL 查询而不是
逐格 COM 调用。
亮点:
① 全参数化,列名表名不硬编码,一套代码适配不同客户表结构;
② 破坏性操作(如排序)先自动备份原始数据到 Original 表;
③ 结果一律输出到新表,绝不改动源数据;
④ 部署只需拷贝 .xll/.dna/.dll 三个文件,双击即用,不需要管理员权限、
COM 注册和证书。
难点:大数据量下的性能与稳定性,靠 OleDb 批量读、进度窗体反馈、分步提交解决。
开发过程中用 AI 辅助排查 Excel-DNA 的集成细节(Ribbon 派生类、
布局引擎、界面本地化、NuGet 版本对齐),把原本要翻文档试错的时间
压到最短。

评论