语言技术
Java、Python、JavaScript系统类型
Windows行业分类
网络安全参考价格
1000演示地址
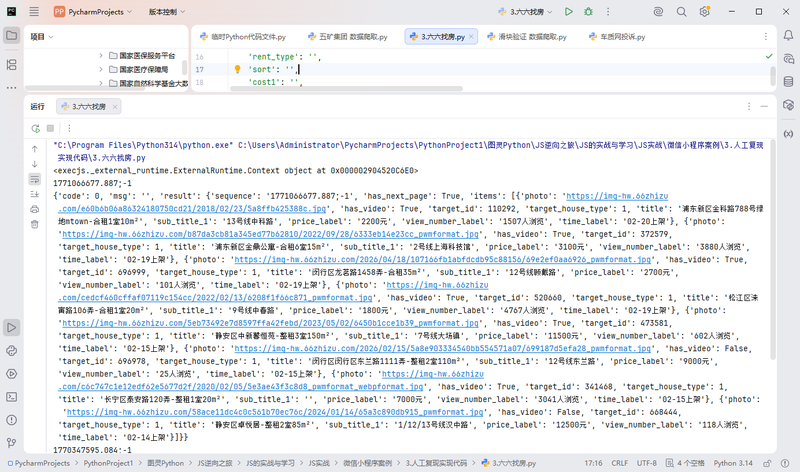
https://66miniapp-api.66zhizu.com/client/search/house
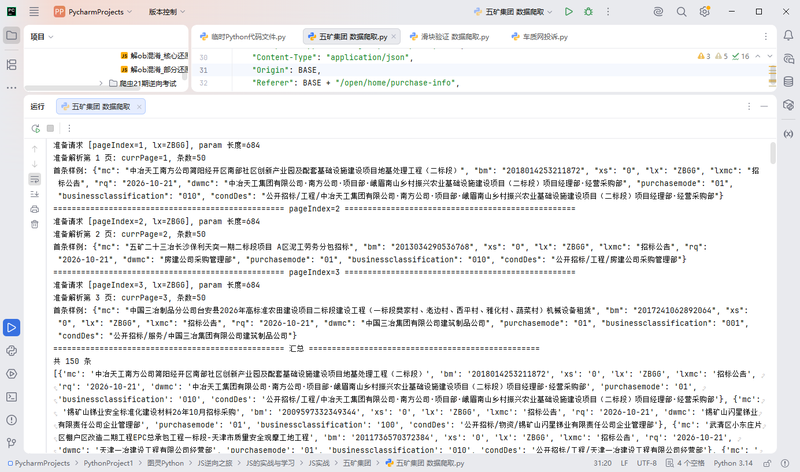
公开招投标公告、建筑市场监管公示、产权交易信息,以及企业公开查询里的列表,都散在不同网站上。页面能打开,人工却不好用:翻页容易漏掉当天新公告;同一条记录在列表和详情里字段对不齐;抄进表格后,日期、编号、地区还要再洗;过几天按关键词或地区回看,对不上当时的原文。立项要解决的就是这件事,把这些公开列表收成自己能筛选、能留档的数据,用来跟踪新发布的招标和公示,对照企业公开资料,而不是对着屏幕一页页抄。做法先定好要哪些列,再按页抓全,列表里没有的金额、正文、主体名称到详情页补,然后入库并导出表格。实际对着做过的页面包括全国建筑市场监管公示、产权交易公告、招投标列表,以及企查查、七麦、欧冶这类要带加密参数的查询页,医保服务平台的接口也单独对过请求和返回。有的站把页码和时间戳放进签名里,浏览器能翻页,照抄地址却拿不到下一页,所以要先把这一页的参数算对,让程序拿到的和屏幕上是同一条。项目不改网站本身,只解决公开信息分散、手工整理慢、翻页中断、加密参数导致列表拿不全。日常要的是三类结果:新公告按时间翻全,不漏当天的条目;列表只有标题时,详情里的金额和主体能补回来,对得上同一条;过几天还能按地区和日期查,不靠临时表格。建筑市场公示、产权交易和招投标列表主要是翻全和留档;企查查、七麦、欧冶多一层签名,查询条件一变参数就失效;医保服务平台要先确认接口返回里哪些字段对应页面上那一条。每个站单独对样例,不把这个站的列名套到另一个站。导出的表要能按地区、日期筛选,只看某一天新出现的条目。收集的范围限于页面上已经公开展示的列表和详情,用来自己筛选和留档。样例里的标题、时间、编号对不上页面,就不进入翻页,避免错误列复制到后面几十页。回看时直接查库和表格,不用再把原来的列表页一页页打开重找。
功能按模块分开,每个网站换配置,不把地址写死在公共代码里。站点配置模块记录列表地址、翻页规则、字段清单和停止条件。列表采集模块按页请求,解析标题、发布时间、地区、编号、链接和状态。详情补全模块进入详情页,把列表没有的正文摘要、金额、招标人或相关主体补上。清洗模块去掉多余空白、换行和全角符号,日期收成同一种写法,用编号或链接去重,避免相邻两页重叠时插入同一条。加密参数模块在翻页前算出这一页的签名或查询参数,页码一变参数跟着变,再发请求。存储模块把整理后的列表放进 MySQL,字段不固定的原始返回放进 MongoDB,方便以后对账。导出模块按时间、地区、关键词选出列,打成能直接打开的表。日志和断点模块记下每一页成功还是失败,失败的页单独重试,已经入库的页不重复抓。源码里没有列表的动态页,先打开页面对条目,再改走抓到的接口。串起来就是:给定一批公开列表,自动翻页、对齐字段、去掉重复,输出能筛选的表,中途断了从上次的页继续。简单列表先用来把翻页和入库跑顺,带签名的公告站再接上同一套导出。列表页输出标题、时间、地区、编号、链接、状态六列,详情页再补摘要、金额和主体名称。去重键优先用公告编号,没有编号就用详情链接。失败页写入日志,包含站名、页码和原因,下次只重跑这些页。导出可以按日期区间和地区过滤,也可以把原始 JSON 留在库里,表里只放整理后的列。动态页和普通列表走同一套清洗、去重和导出,差别只在取数这一步:一个直接请求,一个先对接口。编号、标题、时间、链接这四列每个站都保留,否则无法去重,也无法从表格点回原来的公告。其余列按站增减,金额和主体只在详情里有的站才补。重试只打失败页,成功页的条数记在日志里,条数对得上就不再请求。
这条链路从定字段到出表都是我自己做的。主程序用 Python。请求用 requests,字段用正则、XPath 和 BeautifulSoup 取。每个新站点先只抓一页,把标题、时间、编号和页面逐项对上,样例一致后再打开翻页,避免一上来并发把错误列放大。页数多了以后用多线程和协程分担请求,用 Scrapy 把起始地址、解析和入库串起来,去重和断点放在管道里。源码里看不到列表时,用浏览器开发者工具看真实接口,必要时用 Selenium 打开页面,对照返回和屏幕上是不是同一条。加密参数单独处理:在控制台找到签名函数,分清是 MD5、AES、RSA 还是国密,只把这一小段交给 Python 调用,整份混淆脚本不搬进工程。建筑市场、产权交易、招投标列表走分页入库;企查查、七麦、欧冶重点对签名;医保服务平台把请求和返回先对上再落库。MySQL 存整理后的列表,MongoDB 存原始 JSON。亮点是顺序固定:先对一条,再翻页,最后才加速。难点是各站列名不同,有的签名还跟着页码变,所以站点配置和签名各写各的,公共部分只留请求、解析、去重、重试和导出。豆瓣和招聘列表这些结构简单的页,用来先把翻页和入库跑顺,再接到带参数的公告站点上。签名函数确定之后,用同一页的页码在浏览器和 Python 里各算一次,两边参数一致才进入翻页。入库前再对一次样例行,标题、时间和编号三列必须和页面相同。并发只加在已经对过的站点上,新站保持单线程。日志里能看到每一页的条数,条数突然变成零就停下来查参数,不继续往后翻。建筑市场、产权交易、招投标列表和几家带签名的查询页,都按这个顺序走过。交付时同时给表格和入库记录:表格用来筛选,库里留原始返回。某一列以后要改口径,可以再洗一次,不用把网站重新翻一遍。新站第一页对不齐,就先改解析,不改并发。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论