

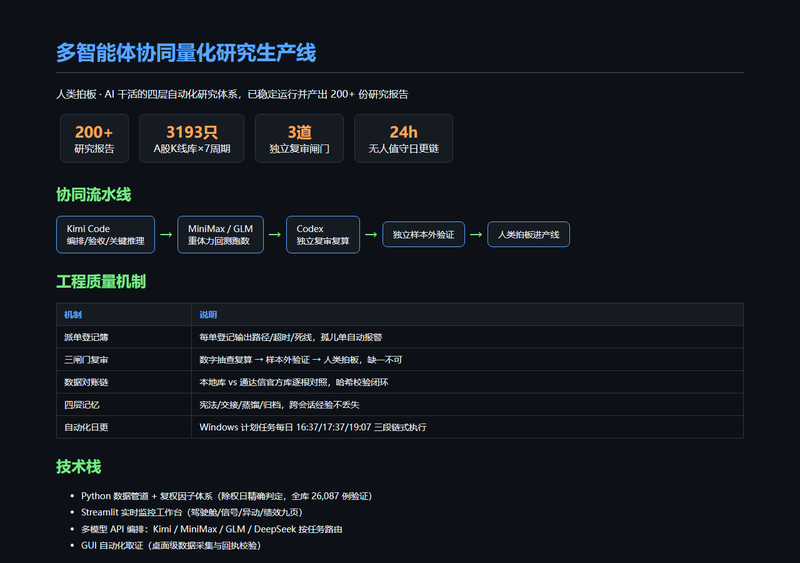
面向需要持续产出数据研究成果的团队与个人。痛点:单一AI跑批量任务成本高,且结果无人复核不敢直接采信,研究经验跨会话丢失,数据更新靠人肉。本生产线用多模型分工协同(编排/重体力跑数/独立复审)加派单登记簿与三闸门验收纪律,实现研究报告的无人值守持续产出,已在量化研究领域稳定运行并产出200余份研究报告。


点击空白处退出提示



面向需要持续产出数据研究成果的团队与个人。痛点:单一AI跑批量任务成本高,且结果无人复核不敢直接采信,研究经验跨会话丢失,数据更新靠人肉。本生产线用多模型分工协同(编排/重体力跑数/独立复审)加派单登记簿与三闸门验收纪律,实现研究报告的无人值守持续产出,已在量化研究领域稳定运行并产出200余份研究报告。
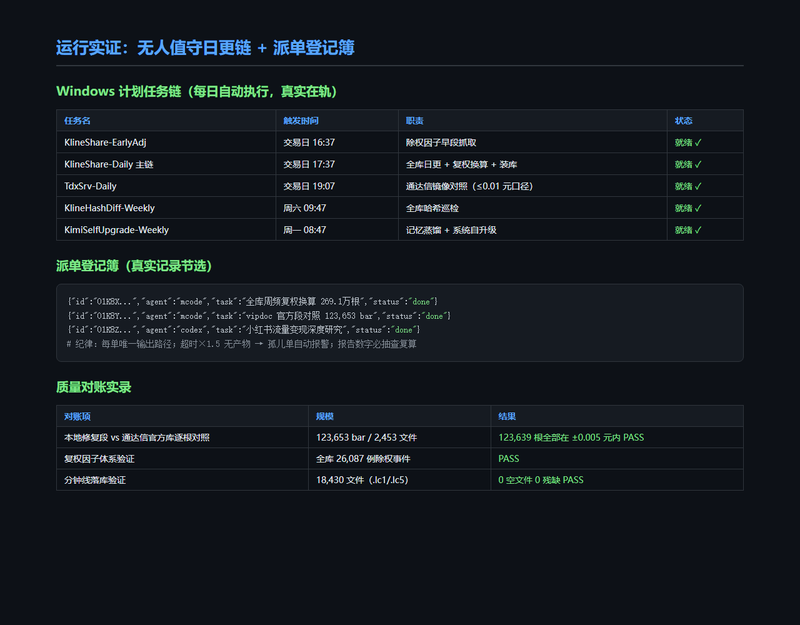
1)多智能体协同流水线:编排层负责任务分解、派单与验收,重体力回测批量派发给订阅制大模型执行,独立复审层对关键数字逐条抽查复算;2)派单登记簿:每单登记输出路径、超时与死线,孤儿单自动报警,并发受控;3)三闸门复审机制:数字抽查复算、独立样本外验证、人类拍板,缺一不可;4)数据对账链:本地库与官方数据源逐根对照,哈希校验闭环,对账精度达0.005元;5)四层记忆体系:宪法、交接、蒸馏、归档分层,跨会话经验不丢失;6)自动化日更链:计划任务每日多段链式执行,全库3193只标的乘7周期数据无人值守更新。
本人负责整体架构设计、派单调度脚本、复审流水线与数据对账链开发。技术栈Python+Shell+Streamlit,Windows计划任务驱动日更,多模型API按任务类型路由调度。系统已稳定运行,产出200余份研究报告,完成12万余根K线的官方源逐根对照验证。亮点:把AI不确定性关进工程笼子——每个数字都要经得起独立复算。

评论