

一套基于大语言模型与物联网技术的智能语音交互系统,主要面向 AI 智能助手、智能硬件及多语言语音交互场景。项目旨在解决传统智能设备语音交互能力有限、多语言支持不足、AI 服务集成复杂等问题。通过搭建统一的后端服务,将语音识别、大语言模型、语音合成及 ESP32 智能终端连接起来,实现从语音输入、智能理解到语音回复的完整交互流程。


点击空白处退出提示



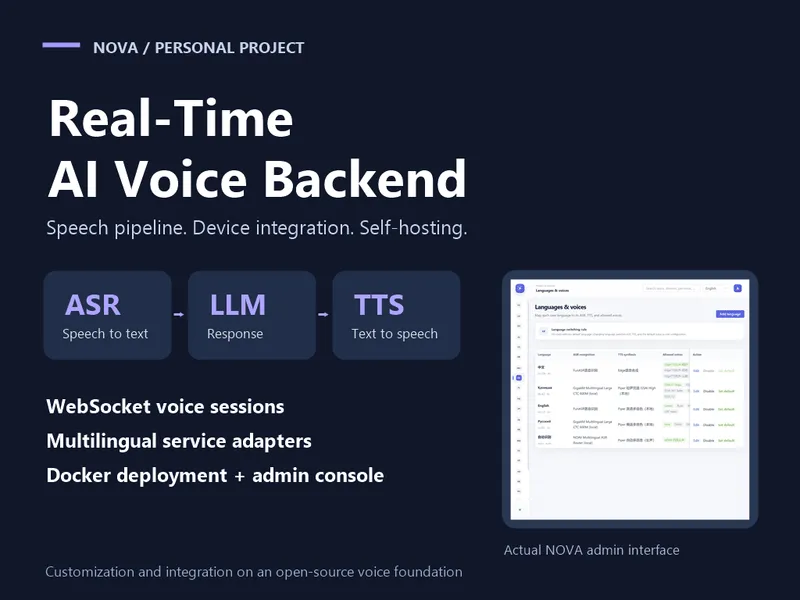
一套基于大语言模型与物联网技术的智能语音交互系统,主要面向 AI 智能助手、智能硬件及多语言语音交互场景。项目旨在解决传统智能设备语音交互能力有限、多语言支持不足、AI 服务集成复杂等问题。通过搭建统一的后端服务,将语音识别、大语言模型、语音合成及 ESP32 智能终端连接起来,实现从语音输入、智能理解到语音回复的完整交互流程。
主要提供智能设备接入、语音处理、AI 模型调用及系统管理等功能。系统接收 ESP32 终端上传的语音数据,通过 ASR 服务完成语音识别,再调用云端大语言模型 API 生成回复,最后由 TTS 服务将文本转换为语音并返回设备播放,实现完整的语音对话流程。
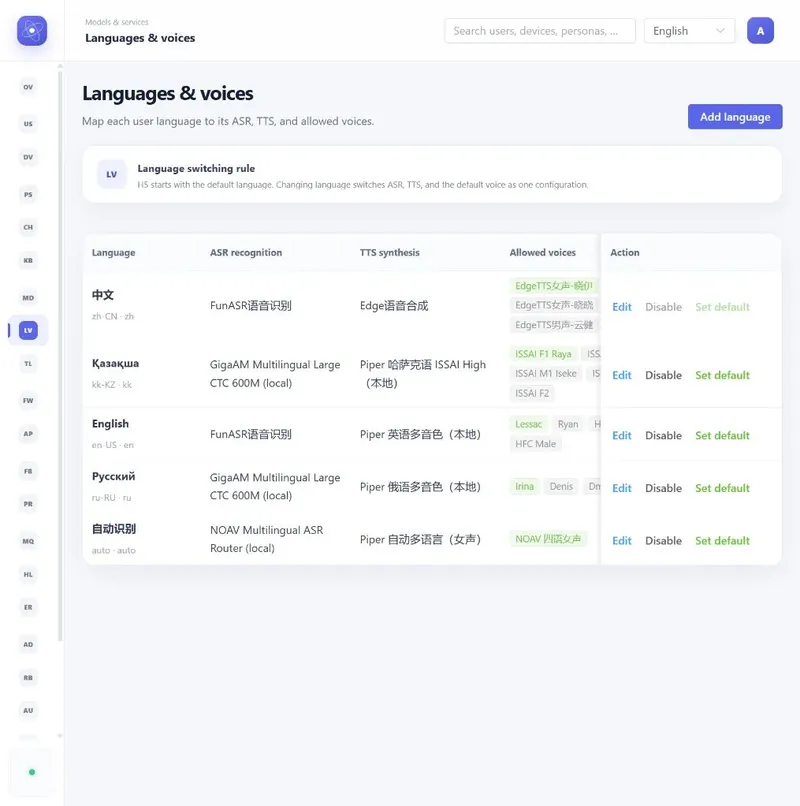
系统集成多个语音识别模型,以及语音合成模型,支持多语言交互。后端还提供设备信息管理、服务参数配置、模型及音色管理、设备能力查询等功能,并通过管理接口与前端系统协同,实现智能语音设备的集中管理和配置。
参与并负责 NOVA 后端服务搭建、AI 能力集成、接口联调及部署维护工作。项目主要采用 Python、Node.js、Docker、Linux 等技术,使用 Docker Compose 管理 ASR、TTS 和设备通信等独立服务,并通过 API 实现服务之间的数据交互。
语音识别方面,采用并行识别及语言判断策略,根据识别结果选择合适的输出,提高多语言场景下的适配能力。语音合成方面,支持不同语言和音色配置。
同时参与 ESP32-S3 设备与后端的通信联调,处理音频数据传输、服务接口适配及设备状态交互,并完成 Ubuntu Linux 云服务器部署、Docker 容器管理、网络配置及运行问题排查,实现从智能终端到云端 AI 服务的完整业务链路。

评论