

项目面向高校、医院及生物医药研发团队的肿瘤基础研究与早期药物发现。科研人员在筛选研究靶点时,需要反复查询患者队列、论文、细胞依赖及蛋白结构等分散数据,人工整理成本高,证据背景不一致,研究过程也难以复现。TST Workbench 将公开癌种患者队列分析、候选靶点解释、小分子研究与实验验证设计整合到统一工作台,帮助研究者梳理支持证据、反证和不确定性,减少跨平台检索与重复整理,形成可追溯、可复核的科研工作流程。


点击空白处退出提示



项目面向高校、医院及生物医药研发团队的肿瘤基础研究与早期药物发现。科研人员在筛选研究靶点时,需要反复查询患者队列、论文、细胞依赖及蛋白结构等分散数据,人工整理成本高,证据背景不一致,研究过程也难以复现。TST Workbench 将公开癌种患者队列分析、候选靶点解释、小分子研究与实验验证设计整合到统一工作台,帮助研究者梳理支持证据、反证和不确定性,减少跨平台检索与重复整理,形成可追溯、可复核的科研工作流程。
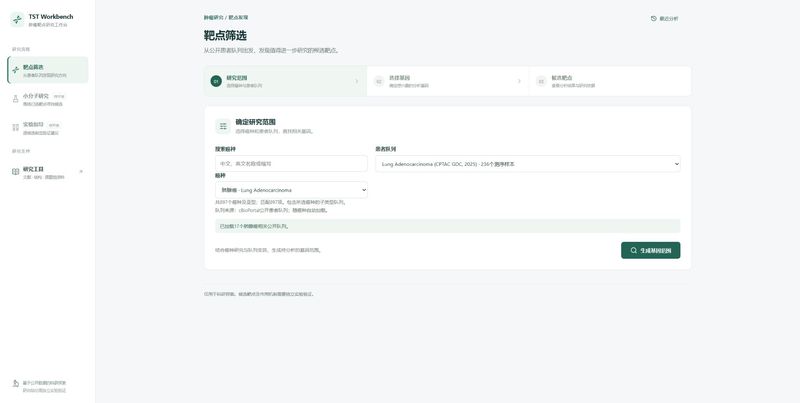
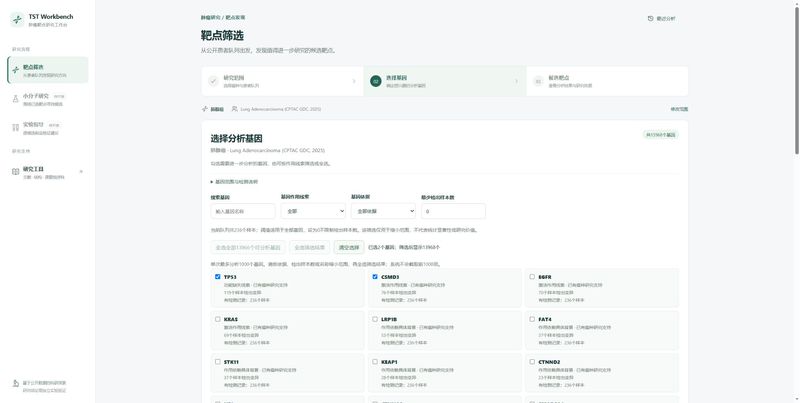
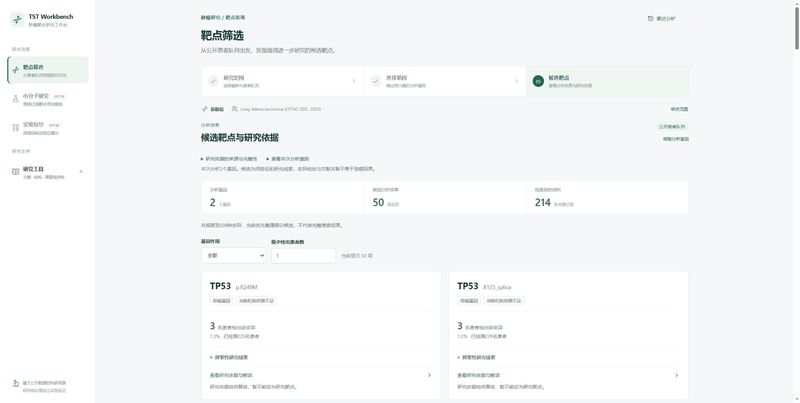
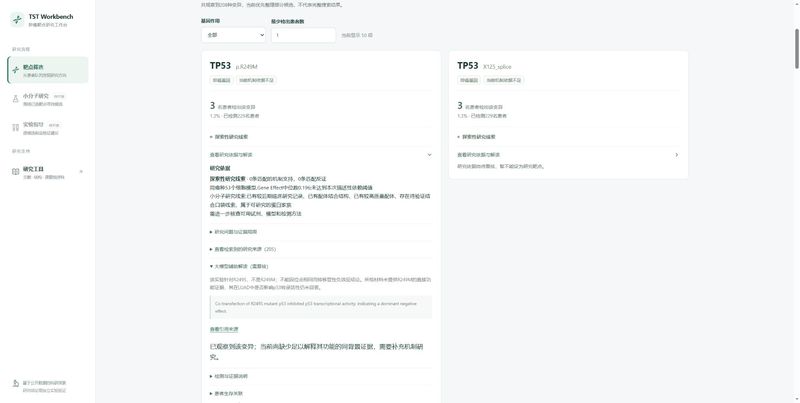
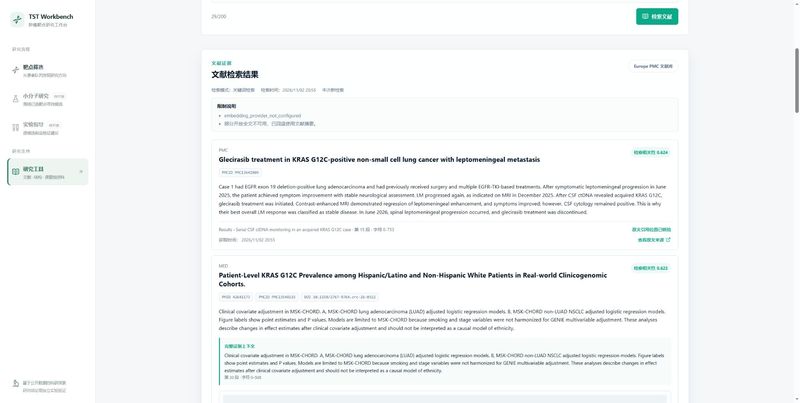
系统围绕“公开患者队列—候选靶点—小分子候选—实验验证建议”提供连续科研流程。支持按癌种、亚型和患者队列生成相关基因范围,结合变异背景、检测覆盖、细胞依赖与文献证据,筛选并解释癌基因及抑癌基因候选;提供文献检索与带出处的证据阅读,关联完整证据句、图注及原文定位;支持蛋白身份核对和三维结构查看。用户选定靶点后,可综合 ChEMBL、PubChem 等数据库研究小分子候选,区分化学身份、活性记录与模型预测,并为每个候选整理实验模型、对照、读出指标和待补条件。系统支持模型配置、人工审核、研究记录保存与恢复,关键结论保留来源和分析依据,供专业人员复核及独立实验验证。
我负责项目需求分析、系统架构、前后端开发、数据源接入及部署测试。后端采用 Python、FastAPI、Pydantic 和 SQLAlchemy,前端使用 Next.js、React 与 TypeScript,采用 PostgreSQL/pgvector 保存研究记录与检索数据,Docker Compose 统一部署。通过 LangGraph 编排有状态研究流程、人工审核与中断恢复,结合 LangChain 相关组件组织模型、工具和检索能力;将数据库查询、确定性统计分析与大模型解读分工协作。重点实现多源证据结构化、基因与蛋白身份对齐、文献证据定位、来源快照及统一模型调用,并通过类型校验、自动化测试和浏览器验证检查流程一致性;模型密钥仅在本次运行内存中使用,不进入研究记录与日志。

评论