• OTA与酒店B2B多渠道聚合分销场景:在复杂的酒店分销生态中,系统需要向下游200+渠道商输出具备绝对价格竞争力的房源,同时向上游对接500+异构供应商。整个行业面临多模报价难以统一标准化清洗、供应商API调用频次严重受限、高并发查单极易引发系统崩溃等多维挑战。
• 百亿级高频变价实时比价场景:酒店价格和库存(RatePlan)具有极高的动态变化特征,系统必须全量存储与计算未来90天全网酒店的全部房型、早餐、取消政策等排列组合数据,数据规模高达百亿级。如何在极短时间内清洗海量变价,并秒级计算出全网最低底价,是保障平台价格壁垒与订单转化率的核心命脉。
• 推拉结合的高控流动态接入:提供超低延迟的 Webhook 推送接收网关与基于供应商配额卡控的分布式智能拉取爬虫,全量、有序地收集多源异构原始报价数据。
• 海量报价实时标准化与极速比价:流式对撞20万级标准酒店/房型Mapping映射,现场基于百亿级明细数据进行多供应商最低价(MIN(Price))的多维聚合算力比价。
• 去中心化高性能二级缓存分发:通过微批增量同步机制将每日计算出的最强优胜底价 RatePlan 打包写入低延迟缓存池,在 150ms 内为下游 200+ 渠道提供低时延、无变价、高性价比的酒店搜索与实时报价。
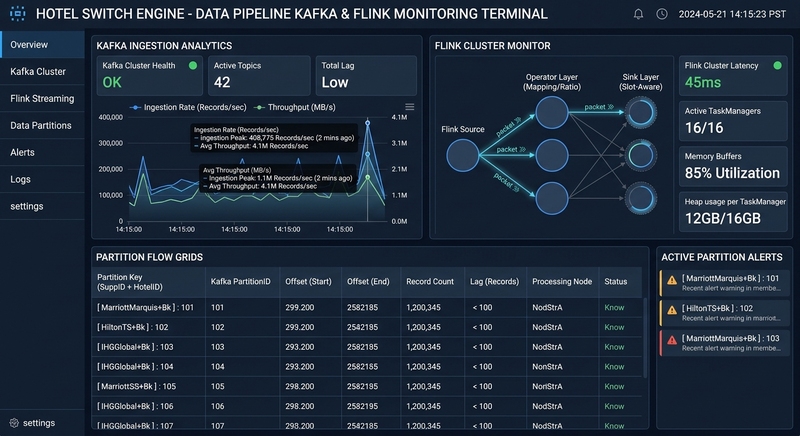
• 推拉错峰接入与局部有序性队列保障:Push链路引入令牌桶算法在入口处实施洪峰阻断;Pull链路采用分布式信号量(Semaphore)动态卡控供应商并发配额,并独创“多维热度矩阵漏斗算法”将长尾冷门酒店拉取频次削减90%。数据统一以 SupplierID + HotelID 作为 Partition Key 注入 Kafka,确保同一酒店的变价严格进入同一分区,保障了消费端的局部绝对有序性。
• Flink内存广播清洗与StarRocks主键模型存储:在 Flink 算力层采用 Broadcast(广播变量)机制将 20万级静态映射表全量驻留 TaskManager 内存实现 O(1) 级流式映射。底层选型 StarRocks 主键模型(Primary Key) 承载 50,000+ Upsert/s 的极高频变价写入,通过天级分区裁剪与酒店ID哈希分桶优化,在 135 亿条 超大规模单表上实现 20ms 内的极速比价聚合查询。
• DataWorks调度时间切片微批增量捞取:在阿里云 DataWorks 平台上配置 5 分钟周期的调度任务,利用内置时间变量 ${bizdate} ${cyctime} 实现数据窗口精准切片,通过 SQL 增量捞取过去 5 分钟内发生变更的优胜底价,杜绝全量重刷,大幅压缩公有云网络 I/O 带宽成本。
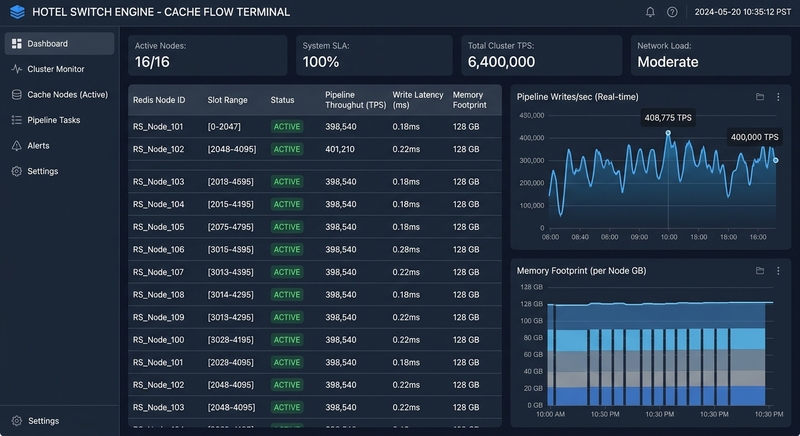
• 手写 Lettuce 自定义 Slot-Aware 智能二级缓存管道:为支撑下游 20,000+ 峰值 QPS 的瞬时查单。DataWorks 联动分布式 Flink 算力集群,基于 Lettuce 客户端手写开发了分布式 Slot-Aware 路由 Sink 算子:
• 拓扑自适应刷新:算子在 open 阶段自动感知并缓存 Redis 物理节点的 [Slot -> 内网IP] 映射表,支持自适应异步刷新以应对 Redis 集群动态扩缩容
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论