

产前诊断的咨询现场有个特点:咨询师一边跟孕妇和家属谈,一边要回答染色体异常、筛查手段、情绪反应、家庭支持这几类问题,答案还得跟机构既有话术一致。培训材料是 13 段咨询示范视频,内容很实,但视频没法在面谈中查。
客户已经有 8 个知识库、3 个应用在跑,这次只能增量补一个库,不能动存量。所以验收标准不是「能答」,而是「答得准,而且存量一点没变」:导入前后要对全部知识库和应用做快照比对。医疗场景还有一条硬约束——结论只给咨询师参考,不直接面向患者输出。


点击空白处退出提示



产前诊断的咨询现场有个特点:咨询师一边跟孕妇和家属谈,一边要回答染色体异常、筛查手段、情绪反应、家庭支持这几类问题,答案还得跟机构既有话术一致。培训材料是 13 段咨询示范视频,内容很实,但视频没法在面谈中查。
客户已经有 8 个知识库、3 个应用在跑,这次只能增量补一个库,不能动存量。所以验收标准不是「能答」,而是「答得准,而且存量一点没变」:导入前后要对全部知识库和应用做快照比对。医疗场景还有一条硬约束——结论只给咨询师参考,不直接面向患者输出。
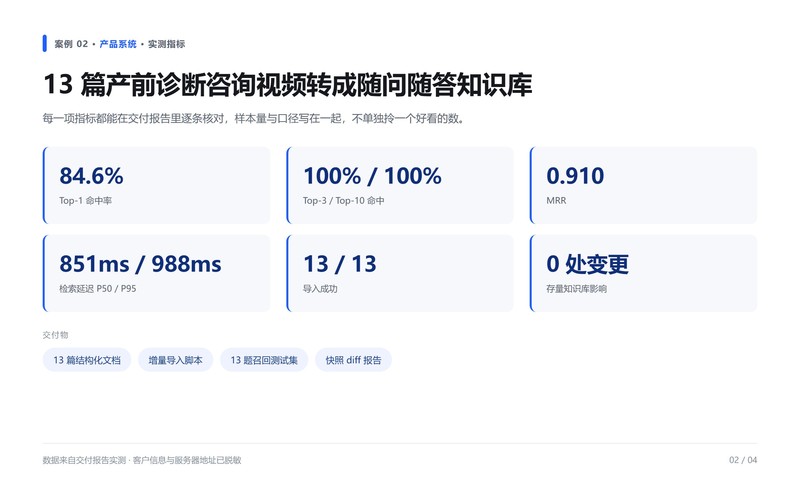
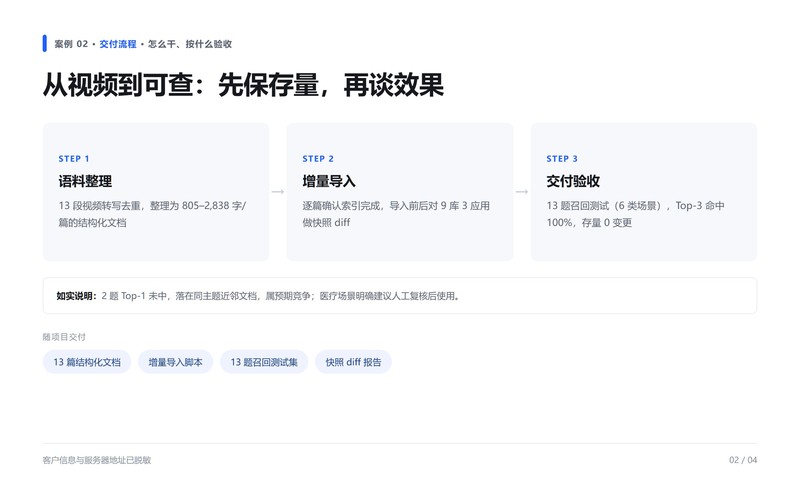
一是视频转写与清洗:13 段视频转成文本,去重、去口语冗余,整理成 13 篇结构化文档,单篇 805–2,838 字。二是增量导入:只写入指定知识库,逐篇确认索引状态完成才进入下一步,避免半途失败留下脏数据。三是召回测试集:按「每篇文档一道题」构造 13 题,覆盖 6 类遗传异常场景,不挑好答的题。四是存量保护验证:导入前后对 9 个知识库、3 个应用做快照 diff,逐项比对配置与文档数。五是检索参数调优:按医疗术语的特点调整切分粒度与召回条数。六是交付说明:附使用边界,写明哪些问题必须由咨询师人工复核后再答复。
我负责全部技术工作:视频转写与清洗、文档结构化、增量导入脚本、测试集构造、快照 diff 工具、调参与交付报告;客户负责提供视频与专业口径校准。技术栈为 Dify 知识库、Python 脚本、向量检索。难点是「零副作用」:导入动作会连带触发重建索引,操作顺序错了会影响其它库。我的做法是先全量快照、再导入、再 diff,任何一项不一致就回滚;同时把导入拆成逐篇确认,失败只影响单篇。另一个难点是评估口径——13 道题里有 2 题 Top-1 没中,我没有调参把它们「修」到 100%,而是逐条看召回结果,确认落在同主题近邻文档(家属支持、唐筛与羊穿内容重叠),属于预期竞争,写进报告而不是藏起来。

评论