

立项原因:解决企业在使用公有云大模型时面临的数据隐私泄露风险,以及海量复杂格式文档(PDF、Word、扫描件)导致的检索效率低下问题。
业务背景:企业内部知识库包含大量非结构化数据,传统关键词搜索无法理解语义,而直接上传给AI又受限于Token长度。本项目通过本地化解析、多格式兼容及RAG(检索增强生成)技术,实现数据不出域的智能化知识问答,赋能企业高效办公。


点击空白处退出提示



立项原因:解决企业在使用公有云大模型时面临的数据隐私泄露风险,以及海量复杂格式文档(PDF、Word、扫描件)导致的检索效率低下问题。
业务背景:企业内部知识库包含大量非结构化数据,传统关键词搜索无法理解语义,而直接上传给AI又受限于Token长度。本项目通过本地化解析、多格式兼容及RAG(检索增强生成)技术,实现数据不出域的智能化知识问答,赋能企业高效办公。
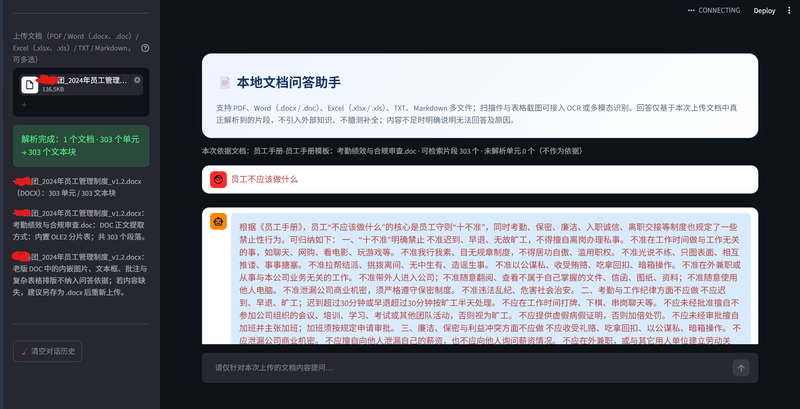
本系统提供开箱即用的私有化知识库解决方案,核心模块包括:
1. 多格式解析引擎:突破单一格式限制,支持 PDF、Word、TXT、Markdown 等多种办公文档的自动化读取与语义分块。
2. 智能向量检索与增强问答:利用本地向量化技术,精准匹配用户提问与文档片段,结合大语言模型(LLM)生成有据可查的回答。
3. 防幻觉约束机制:通过精细化的 Prompt 工程,强制大模型仅在检索到的文档上下文中作答,确保输出内容的准确性。
我的职责:独立负责系统架构设计、大模型API集成及前端UI开发。
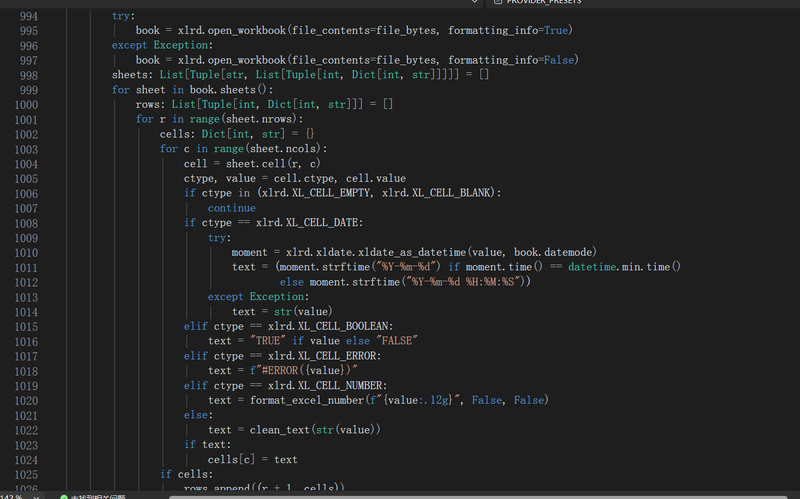
技术实现:采用AI 助手辅助生成了Streamlit交互界面与UI布局等重复性代码 ;后端结合 PyPDF2与 python-docx等库实现异构文档的解析;利用LangChain框架完成文本的切分与上下文拼接;通过模块化的解析函数与滑动窗口分块策略实现不同格式文档的编码兼容与长文本截断。

评论